当サイトではアフィリエイト広告を利用しています。
OpenAIは2026年11月19日、ChatGPTなどの性能劣化を調査し、修正案の作成からデプロイ後の回復確認まで進める社内システム「Performance Factory」の設計と運用実績を公開しました。公開されたのは仕組みと社内での利用結果で、Performance Factory自体はOpenAI社内で使われています。
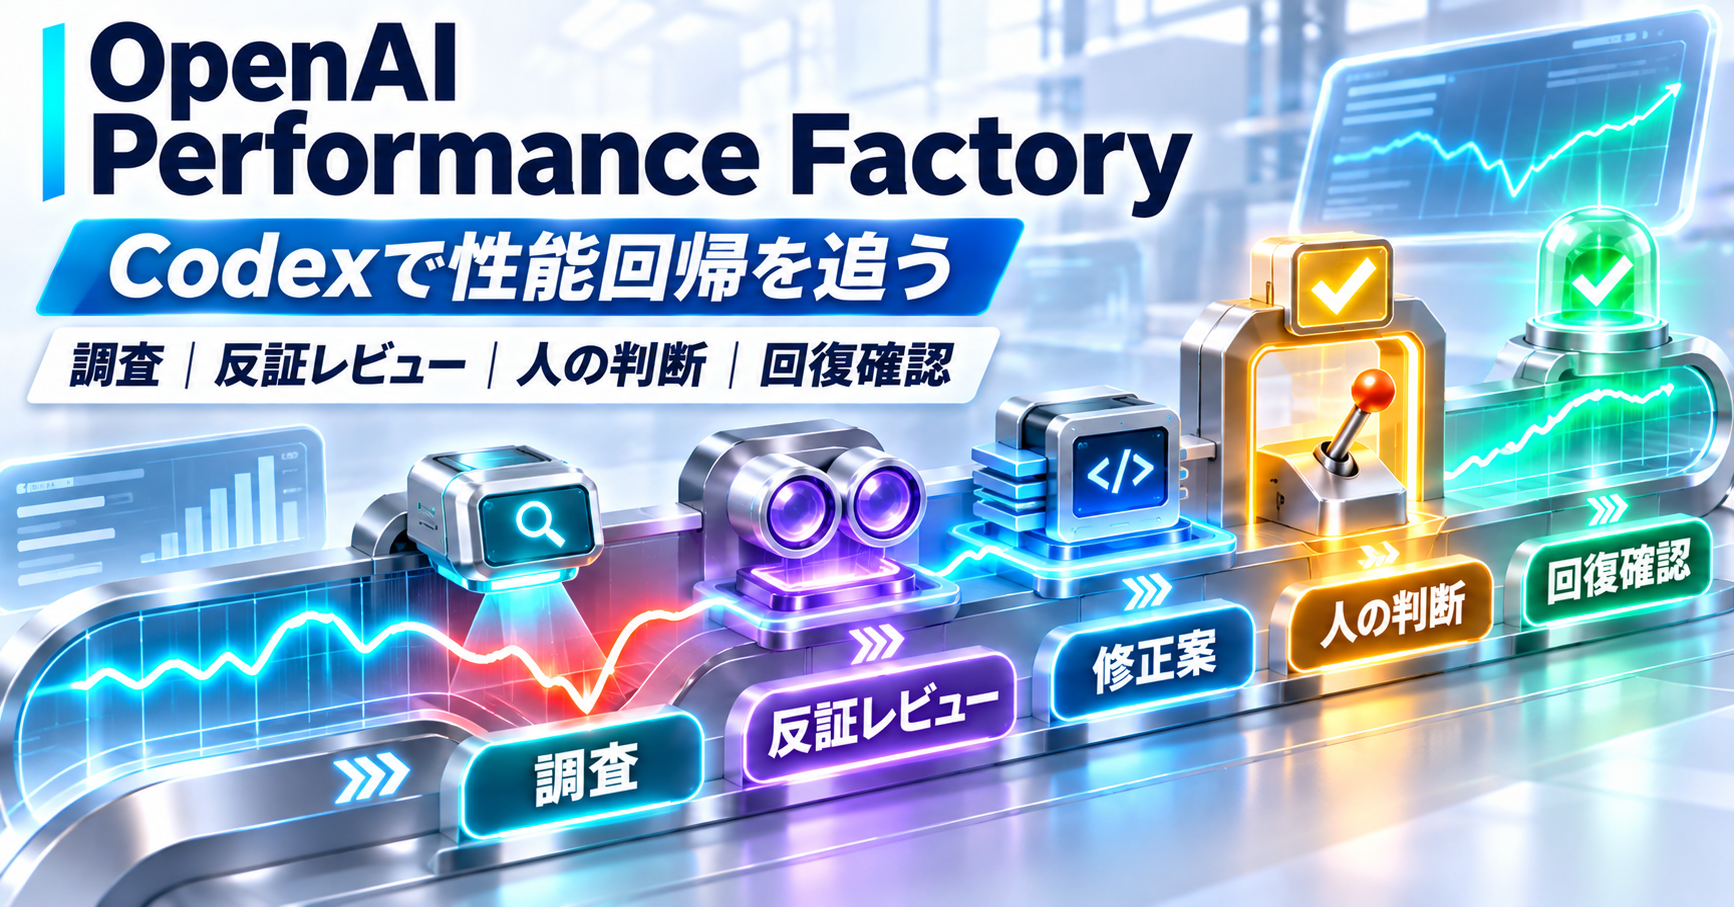
中心となるRegression Workflowでは、性能アラートからタスクを作成し、Codexがメトリクス、ログ、トレース、CPUプロファイル、メモリスナップショット、コード変更を調べます。原因候補は別のCodexセッションが反証レビューし、通過するとCodexが修正案を作成します。修正案も別のCodexセッションが反証レビューし、その後にエンジニアがプルリクエストをレビューしてマージとデプロイを判断します。承認された変更のデプロイ後は、再びエージェントが性能を測り、基準値へ戻ったかを確認します。
3カ月強で1,700件を超える調査を追跡し、600件を超えるケースで原因を特定しました。1日あたりでは17件の自動調査です。原因候補100件を人が手動評価した結果は70%が正確で、残る30%は追加の精査や因果関係の補強が必要と判定されています。
Performance Factoryは、タスク状態を持つ基盤、エージェントの役割分担、人が判断する地点、デプロイ後の検証、継続的な評価を一つのワークフローとしてつないでいます。
- Performance Factoryは本番の性能問題を状態付きタスクとして進める
- Performance Factoryは4つの構成要素で動く
- Regression Workflowはアラートから回復確認までつなぐ
- 原因調査はperf-forensicsと30超の性能ツールを使う
- 原因候補は別のCodexセッションが反証する
- 修正案はCodexが作り、マージとデプロイは人が判断する
- 1,700件の調査実績と70%評価は別の指標
- 評価は調査品質と人への引き継ぎを分ける
- エージェント自体の障害もPerformance Factoryで修復する
- Performance Factoryから読み取れる5つの設計ポイント
- まとめ
- 公式情報・参照先
Performance Factoryは本番の性能問題を状態付きタスクとして進める
Performance Factoryは、性能問題ごとにタスクを作り、そのタスクが現在どの状態にあるか、何が分かったか、次に誰が動くかをシステム側で保持します。
Regression Workflowでは、性能劣化を次のような状態で進めます。
- 調査が必要
- 原因特定
- 修正案あり
- レビュー・デプロイ待ち
- 回復確認
- 解決
エージェントが調査を終えた後にエンジニアのレビューを待つ場合も、タスクの状態と調査結果は残ります。レビューコメントやデプロイ完了など次のイベントが発生すると、別のCodexセッションが同じタスクを引き継いで続行できます。
長時間の運用では、仕事の状態をエージェントの外側へ保存する設計が重要になります。Performance Factoryは、エージェントが交代しても作業を継続できるよう、状態と成果をタスクへ集約しています。
Performance Factoryは4つの構成要素で動く
OpenAIが公開したPerformance Factoryは、次の4要素で構成されています。
| 構成要素 | 役割 | 保持・実行する内容 |
|---|---|---|
| Task service | ワークフローと状態を管理 | 状態、遷移条件、エージェント向けMarkdown指示、人が必要な工程 |
| Dispatch loop | 次に動けるタスクを探して割り当てる | 現在状態を見てCodex turnを開始 |
| Codex in the cloud | 調査・修正作業を実行 | コード、メトリクス、ログ、トレース、CPUプロファイル、メモリスナップショット |
| Subscriptions | 待機中タスクをイベントで再開 | PRレビューコメント、CI失敗、デプロイ完了など |
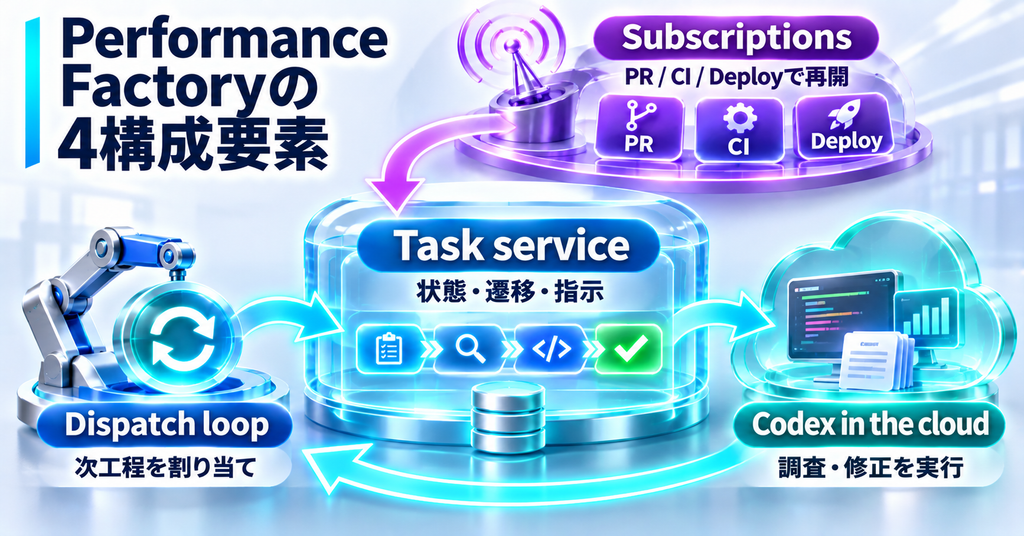
Task serviceでは、エンジニアがワークフローの状態と遷移条件を設定ファイルで定義し、各状態でエージェントが行う作業をMarkdownの指示として記述します。
Dispatch loopは、次の工程へ進めるタスクを定期的に確認し、その状態に対応するCodex turnを開始します。クラウド側のCodexはOpenAI社内ネットワークの環境で動き、性能エンジニアが使う観測ツールへアクセスします。
エージェントはservice identityで実行されます。これにより、権限の範囲を設定し、どの操作がPerformance Factoryから行われたかを追跡できます。
Subscriptionsは、人のレビューやCI、デプロイを待つ工程で使います。待機中にエージェントを動かし続けず、対象イベントが届いた時点でタスクを再び実行可能な状態へ戻します。
長時間エージェントでセッション管理、実行環境、ツール接続をどう分けるかは、OpenAI Agents APIの記事でも整理しています。Performance Factoryとは別の公開サービスですが、エージェントの状態と実行基盤を分けて考える参考になります。
Regression Workflowはアラートから回復確認までつなぐ
Performance Factoryで最初に実運用されたのがRegression Workflowです。
流れは次の9段階です。
| 段階 | 主担当 | 内容 |
|---|---|---|
| 1. 検知 | 監視システム | 性能アラートからタスクを作る |
| 2. 原因調査 | Codex | 悪化した指標、開始時刻、影響リクエスト、変更履歴を調べる |
| 3. 原因候補の反証レビュー | 別のCodexセッション | 反証材料が見つかれば原因調査へ戻し、通過した場合に修正工程へ進める |
| 4. 修正案作成 | Codex | 原因に対応する変更を実装し、PRを作成する |
| 5. 修正案の反証レビュー | 別のCodexセッション | 問題が見つかれば修正案作成へ戻し、通過した場合に人レビューへ進める |
| 6. 人レビュー・マージ/デプロイ判断 | エンジニア | PRと証拠を確認し、マージとデプロイを判断する |
| 7. デプロイ | デプロイ工程 | 承認された変更を反映し、完了イベントでタスクを再開する |
| 8. 回復確認 | Codex | デプロイ後の指標を基準値と比較する |
| 9. 解決・分岐 | Workflow | 回復なら解決、部分回復なら別タスク化、改善なしなら原因調査へ戻す |
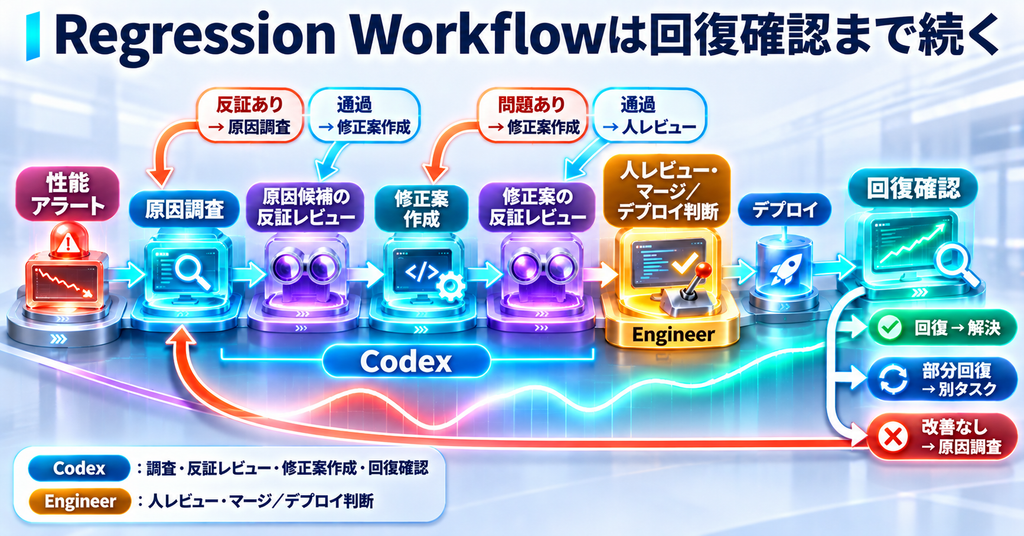
原因候補の反証レビューで反証材料が見つかれば原因調査へ戻り、通過した場合に修正案作成へ進みます。修正案は別の反証レビューを経て、人がマージとデプロイを判断します。承認された変更のデプロイ後もタスクは継続し、性能が以前の基準へ戻ったかを確認します。回復すれば解決、部分回復なら残った遅延を別タスクとして追跡し、改善が見られなければ元の原因調査へ戻します。
AIがコード変更を提案したことと、本番性能が回復したことを別々に確認する設計です。
原因調査はperf-forensicsと30超の性能ツールを使う
OpenAIの性能チームは以前から、CPUやメモリアロケーションのプロファイラを含む30を超える性能ツールを蓄積していました。
Codexを性能調査へ使い始めた当初は、エンジニアがツールを選び、調査の方向を指示していました。その後、調査手順を共有Skill「perf-forensics」へまとめています。
perf-forensicsは、Codexへ次のような調査手順を渡します。
- 性能低下が始まった時点を特定する
- 影響を受けたリクエストを特定する
- デプロイや設定変更との時間関係を調べる
- ログ、トレース、プロファイルから原因候補を絞る
- 関連コードを読み、仮説を証拠で検証する
エージェントはアラート発火時刻より前のデータまで遡り、性能悪化が始まった時点を特定します。さらに、同種リクエストが遅くなったのか、遅い種類のリクエストが増えたのかを比較します。
そのうえで、デプロイ、feature flag、コード変更が影響対象へ届いた時刻と、メトリクス悪化の時刻を照合します。
原因候補は別のCodexセッションが反証する
Performance Factoryでは、別のCodexセッションが原因候補を反証できる証拠を確認してから修正工程へ進めます。
たとえばロールアウトが原因候補なら、ロールアウト対象外の同種リクエストが正常だったかを確認します。ロールバック済みなら、指標が実際に回復したかを調べます。
OpenAIが公開した例では、画像ダウンロードの失敗を原因と判断した調査に対し、別のCodexセッションが「ファイル位置を扱う内部サービスはすでに回復しているのに、画像リクエストの失敗が続いている」と指摘しました。原因説明が継続中の失敗を説明できないため、調査は再開されています。
反証工程では、最初に見つかったもっともらしい説明を因果関係として採用する前に、別セッションで崩せるかを確認します。
原因候補100件を人が手動評価した結果では、70%が正確と判定されました。30%は追加の精査が必要、または因果関係を十分に確立できていないケースです。Performance Factoryは、この評価結果を前提に反証レビューと人の判断を残しています。
修正案はCodexが作り、マージとデプロイは人が判断する
原因が反証レビューを通過すると、Codexが修正を実装し、プルリクエストを作成します。
エンジニアはタスクレポートから、性能低下の概要、影響、原因、修正案、時系列グラフ、CPU flame graph、トレースなどを確認できます。PRへコメントするとSubscriptionがタスクを再開し、別のCodex turnが修正対応を続けます。
現在のRegression Workflowでは、エンジニアがPRをレビューし、マージとデプロイを判断します。キャッシュ追加のように性能とデータ鮮度のトレードオフが生じる変更や、アーキテクチャ判断が必要な変更は、人がサービス全体への影響を見て決めます。
原因候補への反証レビューとは別に、修正案にも反証レビューを行います。原因を直せる変更か、新しい不具合や不要な複雑さを持ち込まないかを別セッションで確認します。
公開されている現在の工程では、人が本番変更の採用判断を担います。OpenAIは将来の方向として、低リスク変更をエージェントが自動で出荷する方法も検討しています。
1,700件の調査実績と70%評価は別の指標
Performance Factoryの公開数字は、工程と分母ごとに分けて読みます。
| 指標 | 公開値 | 何を示すか |
|---|---|---|
| 調査件数 | 1,700件超 | Regression Workflowが追跡した調査数 |
| 原因特定 | 600件超 | root causeまで到達したケース |
| 自動調査 | 1日17件 | 調査処理の運用量 |
| 手動評価 | 100件 | 原因候補を人が確認した評価サンプル |
| 正確と評価 | 70% | 100件の原因候補のうち正確と判定された割合 |
1,700件超は調査件数、600件超は原因特定まで到達したケースです。70%は、100件の原因候補を手動評価したときに正確と判定された割合です。
VentureBeatはOpenAIの性能チームから共有された追加情報として、600件超の原因特定のうち約400件が修正案へ進み、出荷された修正のうち約50件がエージェントの提案に影響されたか一致し、約15件はCodexが作成したPRそのものだったと報じています。
この数字は、原因特定、修正案作成、人による採用、出荷を別工程として扱います。Performance Factoryは、性能問題の大量調査と状態管理を継続的なワークフローへ変えています。
評価は調査品質と人への引き継ぎを分ける
OpenAIはPerformance Factoryの変更を評価するとき、調査そのものと人への引き継ぎを別に測っています。
調査品質は過去の本番障害でバックテストする
過去の性能問題をテストケースとして再利用し、Skillやモデルを変更したときに同じ問題を新しいCodexセッションへ調査させます。
評価では、次を分けて見ます。
- 性能低下が始まった時刻
- 影響規模
- 影響を受けたリクエスト
- 原因候補の順位付け
- 根拠となる証拠
- 何が未確定か
バックテストでは、以前の調査メモ、incident writeup、過去実行の結果を入力から外します。テレメトリの保存期限や、復旧後に得られた情報がヒントになっていないかも確認します。
人への引き継ぎは保存済みタスクで評価する
エンジニア向けサマリーは、保存済みタスクのsnapshotを使って評価します。
別のgraderが、対象システムを詳しく知らないエンジニアでも、
- 何が起きたか
- なぜ重要か
- どのグラフを見るべきか
- 次の行動が証拠で支えられているか
を理解できるか確認します。
エージェントの調査品質と、人が意思決定できる報告品質を分けることで、モデル変更やSkill更新の影響を切り分けられます。
エージェント自体の障害もPerformance Factoryで修復する
Performance Factoryを運用すると、エージェントが使うプロファイラの故障や権限不足も新しい失敗要因になります。
OpenAIは毎日、最近の実行メッセージとログを別のエージェントに確認させ、ツール障害やアクセスエラーを探しています。同じツールエラーが複数の調査を妨げている場合は、その問題を修正するタスクを作ります。
原因が明確ならエージェントが修正案を作り、エンジニアがレビューとマージを判断します。修正後は、以前失敗していた工程をエージェントが通過できるか評価します。
性能問題を調べるエージェントにも監視、障害検知、修復、評価のループを適用している点は、常時稼働するAIワークフローを作るうえで重要です。
Performance Factoryから読み取れる5つの設計ポイント
OpenAIの事例から、本番運用へAIエージェントを入れるときの設計ポイントは次の5つに分けられます。
| 設計ポイント | Performance Factoryでの実装 |
|---|---|
| 状態を外部に持つ | タスクが状態・調査結果・次工程を保持 |
| 作業を小さく分ける | 原因調査、反証、修正、回復確認を別Codex turnへ分離 |
| 人の判断地点を固定する | PRレビュー、マージ、デプロイ判断をエンジニアが担当 |
| 結果まで検証する | デプロイ後に基準値への回復を確認 |
| エージェントを評価する | 過去障害のバックテスト、手動評価、handoff評価を継続 |
UberのAI Software Factoryも、エージェントを開発基盤として運用し、モデル、ツール、コンテキスト、コストを分けて管理しています。大量のAIエージェントを運用する別の設計例として比較できます。
Performance Factoryでは、原因調査、反証、修正案、回復確認を自動化し、本番変更の採用判断を人へ渡しています。評価結果に応じて、この境界を将来広げる設計です。
まとめ
OpenAIのPerformance Factoryは、Codexを本番の性能エンジニアリングへ組み込み、性能アラートから原因調査、原因候補の反証レビュー、修正案作成、修正案の反証レビュー、エンジニアのレビュー・マージ/デプロイ判断、回復確認までを状態付きワークフローでつなぐ社内システムです。
構成はTask service、Dispatch loop、Codex in the cloud、Subscriptionsの4要素です。タスクへ状態と成果を残すことで、Codexセッションや人の担当が切り替わっても同じ性能問題を継続して追跡できます。
3カ月強で1,700件超の調査を追跡し、600件超で原因を特定しました。原因候補100件を人が手動評価した結果、70件が正確と判定されました。1,700件超は調査件数、600件超は原因特定まで到達したケース、100件中70件は原因候補の手動評価結果で、分母と工程が異なります。これらを別の指標として扱いながら、自動化する工程と人の判断を残す工程を調整しています。
Performance Factoryでは、状態管理、役割分担、人の判断地点、結果検証、継続評価の5項目が組み合わされています。本番AIエージェントを設計するときの検討項目として参考にできる事例です。