当サイトではアフィリエイト広告を利用しています。
NVIDIAは2026年11月9日、ロボット向け基盤モデル「GR00T 2」を発表しました。
GR00T 2の特徴は、人間の一人称映像、手持ちグリッパーの実演、複数種類のロボットデータをまとめて学び、対象ロボットが未経験の技能へ適応することです。
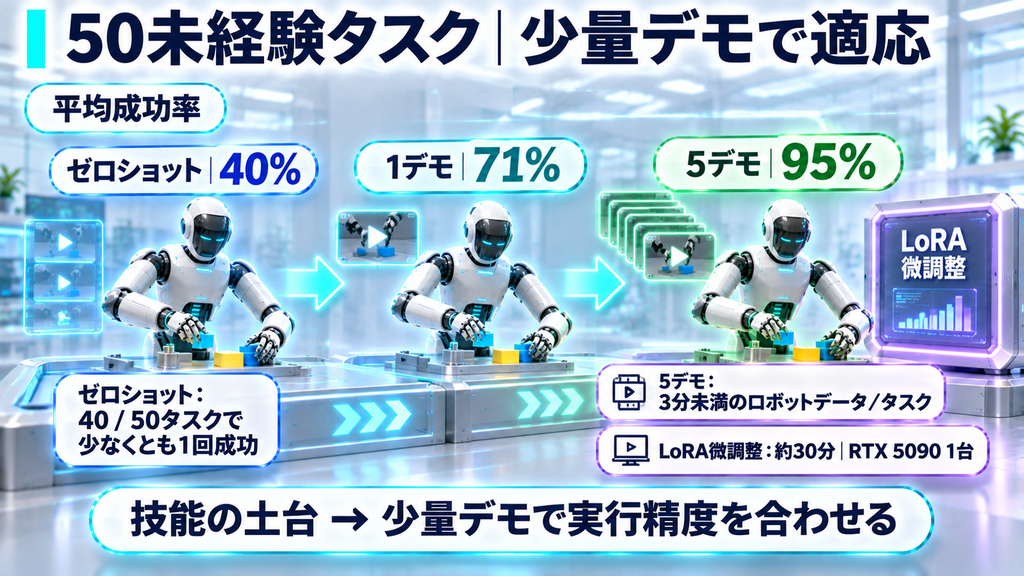
モデルは未来の映像とロボット行動を同時に予測するWorld Action Model(WAM:世界行動モデル)として設計されています。50個の未経験タスク評価では、対象ロボットのタスク固有データを使わないゼロショットで平均成功率40%、1デモで71%、5デモで95%まで上がったとNVIDIAは報告しています。
GR00T 2を見るうえでは、未来映像と行動の同時予測、異なる身体からの技能移転、50タスク評価、LoRAによる少量適応、推論モデルとの役割分担が主要なポイントになります。
GR00T 2は未来映像とロボット行動を同時に予測する
GR00T 2は、NVIDIAがFoundation World-Action Modelと呼ぶロボット基盤モデルです。
従来のVLA(Vision-Language-Action)モデルは、画像や言語指示を入力し、ロボットが取る行動を直接予測する構成が中心です。GR00T 2は、行動と同時に「その行動で次の世界がどう見えるか」という未来映像も予測します。
入力には次の情報を使います。
- 直近のカメラ映像
- 言語によるタスク指示
- ロボットの状態
1つのDiffusion Transformerが未来映像と一定区間の行動を同時に生成し、ロボットごとの小さな出力ヘッドが各機体のモーター指令へ変換します。予測した行動区間を実行した後、新しい観測を取り込み、再び未来映像と行動を予測します。
この構成により、人間映像で見た物体の扱い方や動きの変化を、ロボット行動の学習へつなげやすくしています。
事前学習は人間・手持ちグリッパー・複数ロボットのデータを混ぜる
GR00T 2の事前学習では、3種類のデータを一つの混合データとして使っています。
| データ | 規模 | 主な役割 |
|---|---|---|
| 人間の一人称映像 | 402,730時間 | 人が物体を扱う多様な技能・場面を学ぶ |
| 手持ちUMIグリッパー | 10,184時間・2,897タスク | ロボットに近い操作データを幅広く集める |
| ロボット遠隔操作 | 23,500時間 | 各ロボットの身体と行動の対応を学ぶ |
ロボットデータには、平行グリッパーのアーム、器用な多指ハンド、Unitree G1ヒューマノイドなど複数の機体が含まれます。
人間映像は最も大きな比率を占めます。NVIDIAは人間映像の量を0%、1%、10%、100%と変え、72個の下流タスクで評価しました。人間映像を増やすにつれて、実ロボットのタスク進捗は50%から70%へ上がったと報告しています。
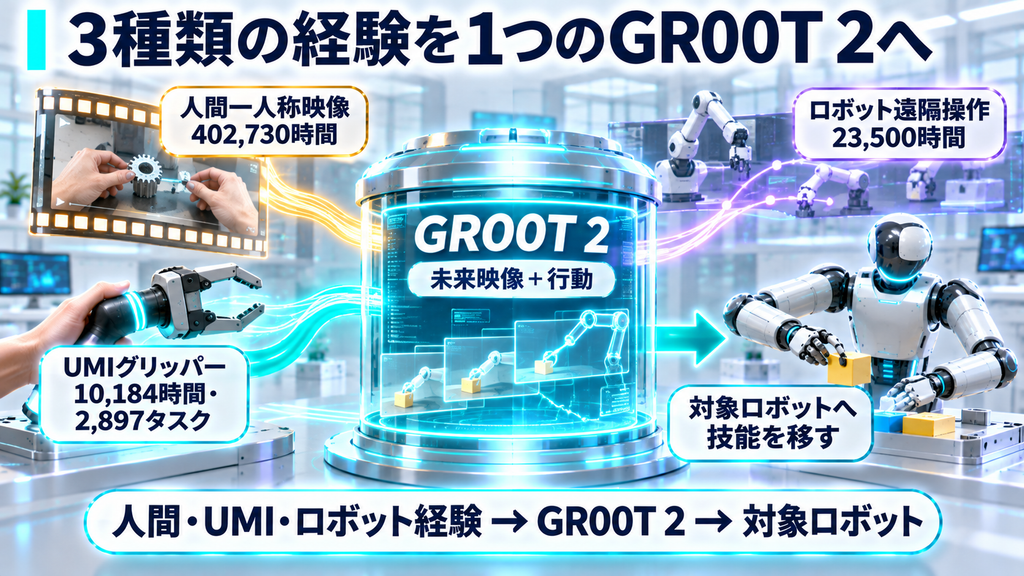
この設計では、対象ロボットで全タスクを最初から収集する前に、人間や別の機体で得た経験を技能の土台として使います。
X-Adaptは人間や別ロボットの技能を対象ロボットへ移す
NVIDIAは、異なる身体・データ源から技能を移す仕組みをX-Adapt(Cross-Adaptation)と呼んでいます。
公開例では、対象ロボットがそのタスクを実演していない状態でも、別のデータ源から技能を移しています。
- 人間 → Dexter:人間だけが実演した化学実験タスクを、2つの5本指ハンドを持つロボットが実行
- UMI → YAM:手持ちグリッパーだけで実演した玩具ダンプトラック組み立てを、別形状のロボットアームが実行
- DexUMI → 多指ロボットハンド:ウェアラブルハンドの実演から、朝食準備やマッチ着火などの両手作業を学習
例として、フィルター紙を設置して洗浄瓶で濡らす化学タスクでは65%、UMIの実演だけで学んだ玩具ダンプトラック組み立てでは60%の成功率が示されています。
これらは特定のタスク・機体での評価結果です。GR00T 2の設計上のポイントは、人間や別のロボットで得た技能表現を、対象ロボットの身体へ写し替える経路を持つことにあります。
50未経験タスクはゼロショット40%、5デモで95%まで上がった
GR00T 2の少量適応を確認する重要な評価が、対象ロボットでは未経験の50タスクです。
50タスクは、人間映像または別ロボットのデータには登場しますが、評価対象の多指ロボット自身はタスク固有の実演を持っていません。
結果は次の通りです。
| 対象ロボットのタスク固有デモ | 50タスク平均成功率 | 適応方法 |
|---|---|---|
| 0件 | 40% | 事前学習済みモデルをそのまま実行 |
| 1件/タスク | 71% | LoRAで追加学習 |
| 5件/タスク | 95% | LoRAで追加学習 |
ここで、平均成功率40%と、50タスク中40タスクで少なくとも1回成功は別の指標です。
ゼロショット時の平均成功率は40%です。一方、50タスクのうち40タスクでは、複数試行の中で少なくとも1回は成功しました。5デモ適応後は平均成功率95%となり、50タスク中37タスクで全試行に成功しています。
5件のデモは1タスクあたり3分未満のロボットデータで、NVIDIAは単一RTX 5090上のLoRA微調整を約30分行ったと説明しています。
ロボット学習の汎化を、位置や積み方などの条件を一つずつ変えて評価する方法は、Ai2 ToyBlocksの記事で詳しく扱っています。GR00T 2の50タスク評価とは別の角度から、未知条件でどこまで性能を保てるかを確認できます。
LoRA適応は少量の対象ロボットデータで精度を詰める
LoRA(Low-Rank Adaptation)は、モデル全体を大きく更新する代わりに、追加する小さなパラメータを学習してモデルを特定タスクへ適応させる方法です。
GR00T 2の50タスク評価では、事前学習済みモデルへ対象ロボットの1件または5件の実演を追加し、LoRAで約6エポック学習しています。
ゼロショットで失敗した試行の多くについて、NVIDIAは「手順の意図は合っているが、一つの動作で精度が足りない」ケースが多かったと説明しています。
この評価では、人間・別ロボットから持ち込んだ技能の土台へ、対象ロボットの少量データで実行精度を合わせる流れになっています。
推論モデルとGR00T 2は「何をするか」と「どう動くか」を分担する
GR00T 2は、長い作業全体の計画を担う推論モデルと組み合わせる構成も評価されています。
NVIDIAのAgentic GR00T 2では、推論モデルをSystem 2として使います。推論モデルはタスクを分解し、進捗を確認し、必要に応じてコードによる復旧操作を選びます。
GR00T 2はWAM API経由で呼ばれ、接触を伴う細かな操作を担当します。
役割を整理すると次の通りです。
| 層 | 主な役割 |
|---|---|
| 推論モデル | 何をするか決める、手順を分解する、進捗を確認する、復旧方法を選ぶ |
| GR00T 2 | 物体へ接触し、つかむ・運ぶ・差し込むなどの動作を実行する |
| コード化された技能 | 位置合わせや復旧など、明示的に記述できる操作を補助する |
玩具3種類の連続組み立て評価では、推論モデルを組み合わせた構成で100試行中98回、97回、97回の成功が報告されています。同じ追加学習済みポリシーを単独で使った場合は71〜84回でした。
この構成では、高位の判断を推論モデル、接触動作をGR00T 2へ分ける設計になっています。
GR00T 2を見るときは「転移」と「適応」を分けて評価する
GR00T 2の結果を読むときは、少なくとも次の4点を分けると整理しやすくなります。
1. 事前学習で何を持ち込めるか
人間映像や別ロボットのデータから、対象ロボットが未経験の技能をどこまで実行できるかを見ます。50タスク評価ではゼロショット平均40%でした。
2. 少量データでどこまで詰められるか
対象ロボットの1件・5件の実演を追加したとき、成功率がどこまで伸びるかを見ます。今回の評価では71%、95%へ上がっています。
3. 身体の違いをどこまで吸収できるか
人間、手持ちグリッパー、平行グリッパー、多指ハンド、ヒューマノイドでは身体構造が異なります。対象機体でタスク固有データを使わない転移と、機体固有の追加学習を分けて確認します。
4. 高位判断を誰が担うか
長い作業では、推論モデルが手順と復旧を管理し、GR00T 2が物理操作を担当する構成も選べます。ロボット基盤モデル単体の成功率と、エージェントを含むシステム全体の成功率を分けて評価します。
まとめ
GR00T 2は、未来映像とロボット行動を同時に予測する世界行動モデルです。
事前学習では、人間の一人称映像402,730時間、手持ちUMIグリッパー10,184時間、ロボット遠隔操作23,500時間を組み合わせています。人間や別ロボットで得た技能を対象ロボットへ移し、その後に少量の対象ロボットデータで実行精度を合わせる設計です。
50未経験タスクでは、ゼロショット平均成功率40%、1デモで71%、5デモで95%という結果が示されました。5デモは1タスクあたり3分未満で、LoRA適応は単一RTX 5090上で約30分と報告されています。
GR00T 2の評価では、ゼロショットで持ち込める技能、少量データでの適応幅、身体の違いを越える転移、高位推論との役割分担を分けて見ることで、ロボット基盤モデルの汎化性能を具体的に比較できます。
公式情報・参照先
- GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and Adaptation|NVIDIA Research
- GR00T 2 Whitepaper|NVIDIA Research
- Practice Makes Precise: At CoRL, NVIDIA and Partners Reveal How Robots Rehearse Delicate Work in Simulation|NVIDIA Blog
- What Is a World Action Model (WAM)?|NVIDIA
- Human-1M-100K|Hugging Face