当サイトではアフィリエイト広告を利用しています。
Ai2は2026年11月6日、ロボット学習用のオープンなシミュレーション基盤「ToyBlocks」を公開しました。
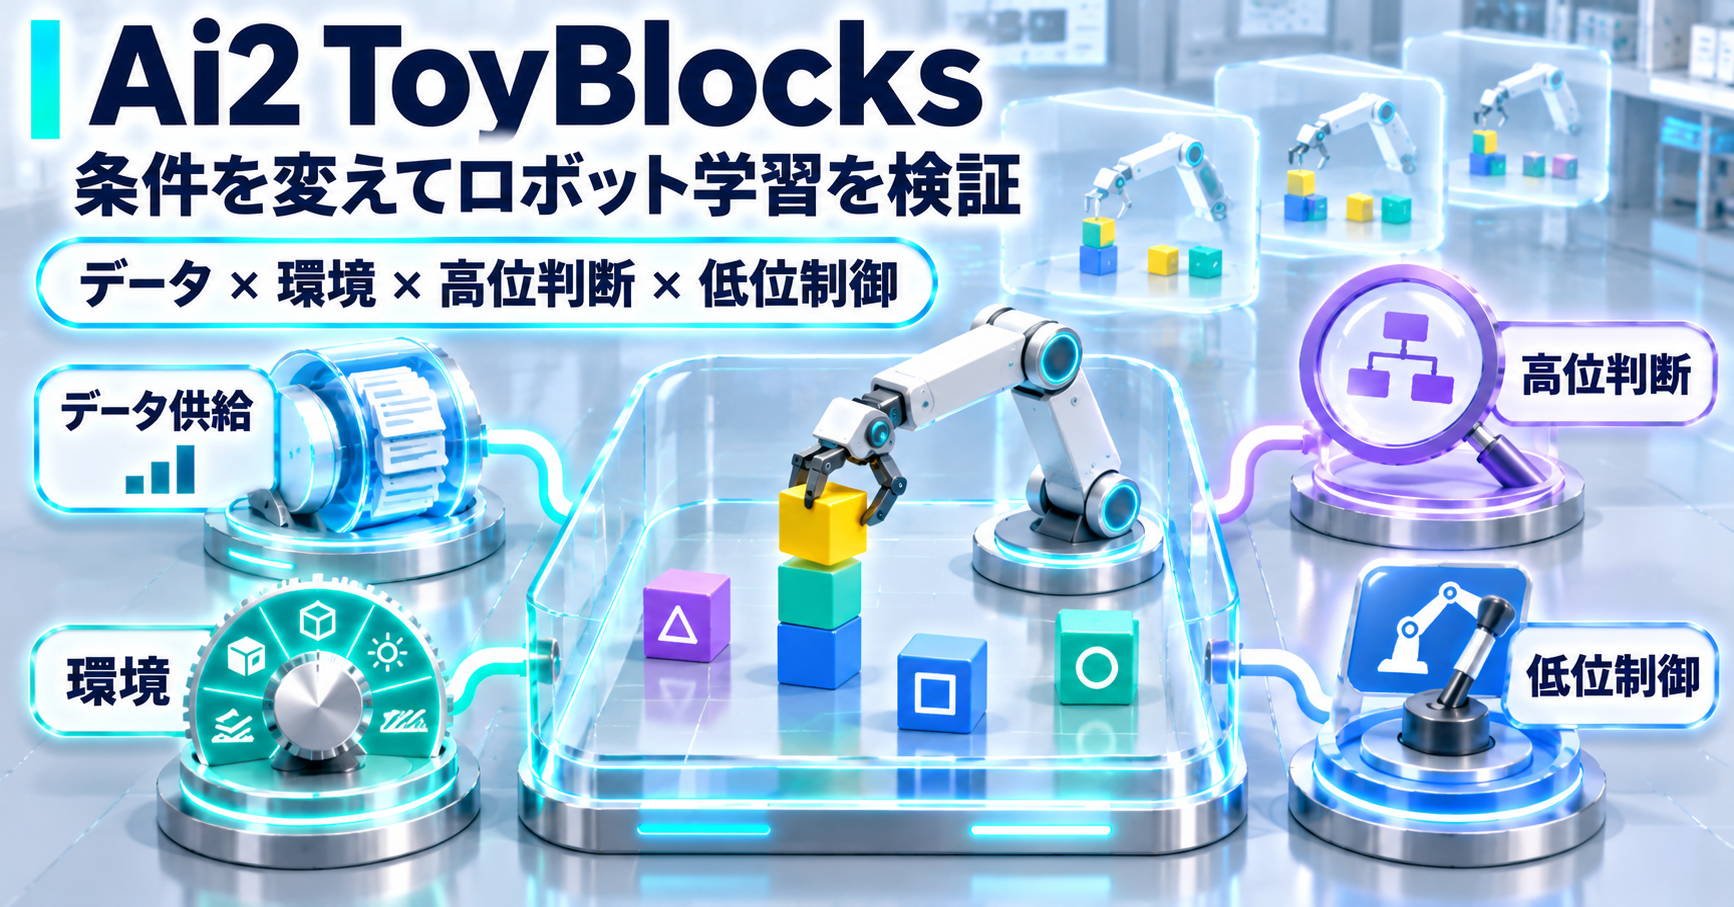
ToyBlocksは、机上のロボットアームと積み木に範囲を絞った実験環境です。Ai2が「FoundationWorlds」と呼ぶ構想の第1弾で、学習データ、モデル、評価条件を一つずつ変え、成功・失敗の原因を追えることを重視しています。
積み木を押す、裏返す、回す、積むといった物理操作に加え、文字や絵が見える面を探して並べる課題も作れます。ロボットは物理操作と高位の判断を組み合わせる必要があります。
ToyBlocksでは、何を変えた結果として性能が変わったのかを再現可能に検証できます。
FoundationWorldsはロボット学習の条件を固定・変更できる実験場
Ai2はFoundationWorldsを、特定のロボット環境へ対象を絞った制御可能なシミュレーション世界として説明しています。
各FoundationWorldには、課題と学習デモを自動生成する仕組み、モデルを評価する仕組み、行動を継続的に測る指標を組み合わせます。
ToyBlocksでは、次の4条件を設計要件にしています。
| 要件 | ToyBlocksでの実装 |
|---|---|
| 現実に近い物理・見た目 | ロボットアーム、積み木、摩擦、カメラ、照明などを再現 |
| 課題・デモの大規模自動生成 | TAMPとスキル群でデモを自動生成 |
| 推論と器用さの両方が必要 | 文字探索、配置判断、押す・裏返す・積む操作を組み合わせる |
| 対象領域内を広くカバー | ブロック配置、サイズ、積み方、技能の組み合わせを変える |
対象を机上の積み木に絞ることで、各ブロックの位置、向き、文字、目標状態までシミュレータ側で把握できます。
この「正解状態が分かる」性質が、失敗原因の切り分けに使われます。
ToyBlocksは課題から学習デモまで自動生成する
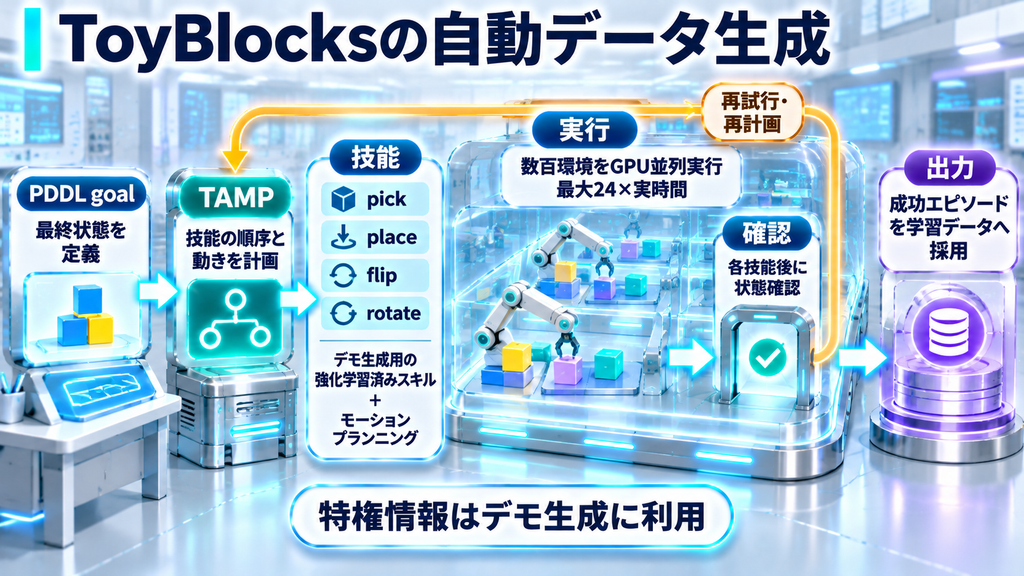
ToyBlocksのデータ生成は、最終状態を表す目標から始まります。
課題はPDDLという形式で、「赤いブロックを緑のブロックの上に置く」「指定した面を上へ向ける」といったゴールとして定義します。
次に、TAMP(Task and Motion Planning:課題の手順とロボットの動きをまとめて計画する仕組み)が、必要なスキルの順番を決めます。ブロックを動かす前に、着地点が空いているか、グリッパーが届くか、別のブロックを先に退避する必要があるかも確認します。
短い物理スキルには、次のような動作があります。
- pick:つかむ
- place:置く
- flip:別の面へ裏返す
- rotate:回転させる
デモ生成では、TAMPが呼び出す短い物理スキルの実行に、強化学習で用意したスキルとモーションプランニングを使います。ここでの強化学習は自動デモを作る側のスキル生成・実行に使うもので、後述するToyBlocksパッケージへ統合予定のRL学習機能とは別です。シミュレーション内では、実機から直接は得られないブロックの正確な位置・向きなどの特権情報も利用できます。
計画した動作は実行後に状態を確認し、失敗時は再試行や再計画を行います。最終ゴールを満たしたエピソードだけを学習データへ採用します。
1台のGPU上で数百環境を並列実行でき、Ai2の実行では最大で実時間の24倍の速度でデモを生成しています。
初期公開データは8万5,336件の長期デモ
初期公開では、8万5,336件の長期デモが用意されています。セットによって1件の長期デモは約6〜12個の短いスキルデモで構成されます。
公開データ全体では、約1,600時間分のロボット実行、約1億4,400万フレームを収録しています。プロジェクトサイトでは、約3万件の学習問題と600件の検証問題も案内されています。
遠隔操作によるデモは0件です。
データ生成を自動化すると、研究者はどのスキルをどの割合で増やすかまで操作できます。
たとえば、回転デモを増やす、特定の位置だけで学習する、異なる積み高さを学習から外す、といった条件を作り、その条件を変えた結果を同じ評価環境で比較できます。
高位判断と低位制御を分けると、どこで失敗したかを追える
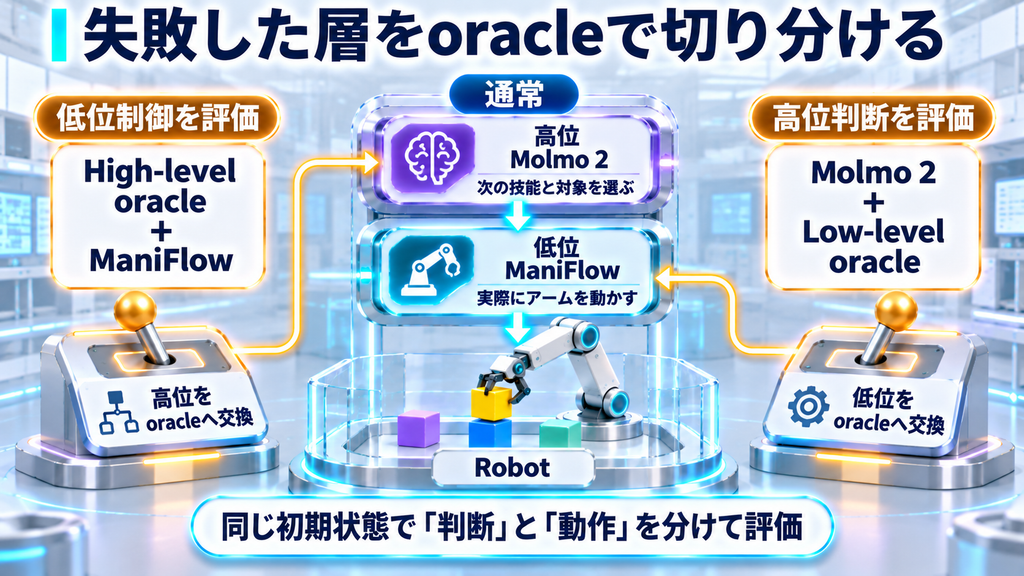
ToyBlocksの学習モデルは、高位判断と低位制御を分けた2層構造でも評価できます。
Ai2の公開例では、Molmo 2が高位モデルとして「次にどのスキルを、どのブロックへ実行するか」を決めます。ManiFlowは低位モデルとして、実際にロボットアームを動かします。
失敗したときに重要なのは、計画が悪かったのか、動作実行が悪かったのかを分けることです。
ToyBlocksには、片方を正解動作を返すoracleへ差し替える評価モードがあります。
| 評価モード | 高位 | 低位 | 確認できること |
|---|---|---|---|
| Full system | Molmo 2 | ManiFlow | システム全体の性能 |
| Asynchronous high level | エピソード開始時とスキル終了時にMolmo 2を呼ぶ | ManiFlow | 高位モデルの呼び出し回数を減らした全体性能 |
| High-level oracle | 正解プランナー | ManiFlow | 低位制御の性能 |
| Low-level oracle | Molmo 2 | モーション計画スキル | 高位判断の性能 |
| Replay | なし | 記録済み動作 | データと評価環境の整合 |
同じ初期状態から比較できるため、「成功率が下がった」という結果を、判断側と制御側へ分解できます。
位置や積み高さだけを変えると、汎化の弱点が見える
ToyBlocksの初期実験では、VLA(Vision-Language-Action:画像と言語からロボット動作を出すモデル)の空間汎化も検証しています。
Stack、Unstack、Flip、Rotateの4課題で、ManiFlow、π0.5、MolmoAct 2を追加学習しました。同じ学習領域で評価した成功率は平均72〜90%でした。
そこから、学習時と評価時の条件を一つずつ変えています。
- テーブル左側だけで学習し、右側で評価する
- 内側の領域で学習し、外側で評価する
- 2段・5段の積み方で学習し、3段・4段で評価する
- 2段・3段で学習し、4段・5段で評価する
条件を少し変えると、初期結果では成功率が大きく低下しました。
この環境では、学習条件も個別に変更できます。Ai2は、別タスクのデータも混ぜて学習するco-training、本学習の前に追加の学習段階を入れるmid-training、動作を絶対値ではなく変化量として表すdelta action、将来の視覚状態の予測を行動学習へ加えるWorld Action Modelなどを比較しています。
実験軸で見ると、co-trainingはデータ構成、mid-trainingとWorld Action Modelは追加の学習・補助学習、delta actionは動作の出力形式を変える方法です。
例として、テーブル右半分への外挿ではco-trainingが平均45ポイントの改善を示しました。新しい積み高さの評価では、MolmoAct 2にWorld Action Modelとco-trainingを組み合わせた条件で成功率が29%から80%へ上がっています。
この種の実験では、変更した要因を限定することで、データ構成、学習段階、出力形式、補助学習のどれが汎化へ効いたかを追えます。
失敗状態から新しい学習データを作るTAMPER
ToyBlocksには、評価中に失敗した状態を次のデータ生成へ戻すTAMPER(TAMP Expert Relabeling)もあります。
評価で失敗またはタイムアウトした最終状態を保存し、計画器がその状態から新しい正解デモを作ります。
流れは次の通りです。
- 評価で失敗状態を保存する
- 失敗した場面を確認する
- TAMPがその状態から正解デモを再生成する
- 次の学習データへ追加する
- 再学習して同じ種類の失敗が減るか確認する
データ生成と評価が同じ世界の状態表現を共有しているため、失敗を新しい訓練例へ戻せます。
TAMPERでは、「どこで失敗したか」の記録から、その失敗を埋めるデータを追加した後の改善確認までを一つの実験ループで回せます。
シミュレーション結果は実機でも近い傾向を示した
ToyBlocksでは、実機への転移も評価しています。
Molmo 2とManiFlowをToyBlocksデータだけで学習し、実世界のデモを追加せず、Franka FR3アームとRobotiqグリッパーで評価しています。
低位の単一スキルについて、ManiFlowの成功率はシミュレーション80.0%、実機81.1%でした。
高位のMolmo 2と低位のManiFlowを組み合わせた3文字の積み木課題では、シミュレーション55.5%(111/200)、実機50.0%(15/30)でした。
実機側の長期課題は30試行で、文字が見えて正しい向きになっている最も簡単な設定です。Ai2も、幅広い結論を出すには追加試行が必要だとしています。
実機転移では、シミュレーション側の関節摩擦などを実機へ合わせるsystem identification、物体サイズ・摩擦・テーブル高さ・照明・背景・カメラ条件を変えるdomain randomizationも使っています。
ToyBlocksの現在の公開範囲
ToyBlocksでは、次のものが公開されています。
- シミュレーション資産
- 課題・デモの自動生成ツール
- 自動生成済みデータ
- Molmo 2ベースとManiFlowベースの学習済みモデル
- 学習コード
- 評価コードと検証セット
- データ生成・評価のドキュメント
コード本体はApache License 2.0で公開されています。GitHubリポジトリ内の一部サブモジュールや取得する外部資産には、それぞれ別のライセンスがあります。
初期公開時点では、研究者がToyBlocks上でRL学習を回すための統合機能は現在のパッケージに含まれておらず、Ai2は後続リリースで追加する方針を示しています。デモ生成工程で使う強化学習済みの物理スキルは現在の仕組みに含まれます。より大規模なデータセット、追加スキル、包括的なベンチマークも次の公開対象として案内されています。
ToyBlocksから見えるロボット学習の評価軸
ToyBlocksの設計を、ロボット学習の評価方法として見ると、確認したい軸は5つに分けられます。
1. データ量
デモを増やしたとき、性能がどこまで伸びるかを測ります。
2. データ構成
押す、裏返す、回す、積むなど、どの経験を何割含めると新しい課題へ効くかを比較します。
3. 環境条件
位置、積み高さ、サイズ、摩擦、照明などを変え、学習範囲内の補間と範囲外への外挿を分けて確認します。
4. 高位判断と低位制御
計画側と動作側をoracleで差し替え、失敗した層を切り分けます。
5. シミュレーションから実機への転移
同じ技能・課題をシミュレーションと実機で比較し、差がどこへ出るかを確認します。
この5軸を同じ環境で回せるため、ToyBlocksはロボット学習を条件ごとに比較する実験基盤として使えます。
まとめ
ToyBlocksは、机上のアームと積み木に範囲を絞ったオープンなロボット学習用シミュレーションです。
課題・デモを自動生成し、学習データの量や構成、環境条件、高位判断、低位制御を個別に変えて評価できます。
初期実験では、学習領域内で高い成功率を出したVLAでも、位置や積み高さを変えると性能が大きく下がる例が確認されました。oracle評価を使えば、その失敗が計画側か動作側かをさらに分解できます。
ロボットAIを評価するときは、最終的な成功率に加えて、どの条件を変えたときに性能が崩れ、どのデータや設計変更で回復したかを見ることが重要になります。
ToyBlocksは、その因果を追うための「小さく制御された世界」をオープンな研究基盤として提供しています。