当サイトではアフィリエイト広告を利用しています。
Codexでは、修正内容が決まっている実装から、複数システムにまたがる設計まで幅広い仕事を扱えます。必要な判断力は仕事によって違うため、モデルを使い分けることで開発時間と費用の両方を調整できます。
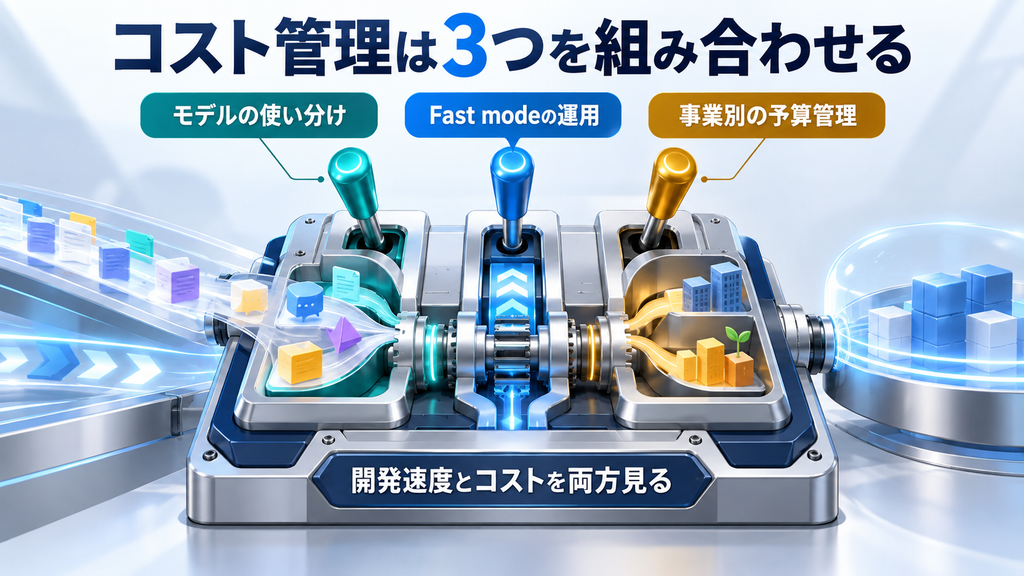
LegalOn Technologiesは、Codexの利用を社内へ広げた後、GPT-6 Luna・GPT-6.1 Sol・GPT-6 Astraの役割分担、Fast modeの原則制限、部門・個人別の予算管理を導入しました。
2026年10月8日に公開されたOpenAIの導入事例では、開発速度を維持しながら、GPT-5.5を主力としていた運用との比較で日次推計コストを約65%削減したと報告されています。
削減対象は日次推計コストです。モデルの役割分担に加え、応答速度の設定と予算配分を見直した結果として報告されています。
この記事では、LegalOnの実際の運用を確認したうえで、個人開発や少人数チームでも取り入れられる仕事の分け方、失敗時のモデル切り替え、使用量と成果の測り方を整理します。
LegalOnのCodex運用で変わったこと
| 項目 | 変更前 | 変更後 |
|---|---|---|
| モデル選択 | 主力のGPT-5.5をFast modeで広く利用 | Luna・Sol・Astraを仕事の難しさで選ぶ |
| Fast mode | 開発メンバーへ制限なく提供 | 原則制限し、必要時に個別申請 |
| 利用枠 | まず利用を広げ、実務で試す | 部門・グループ・個人の単位で予算枠を管理 |
| 現場への展開 | エンジニアの試行錯誤が中心 | 専門チームが検証し、マネージャーが選択基準を共有 |
| 投資判断 | 開発速度や利用状況を見る | 機能リリースと顧客価値に結び付ける指標を構築中 |
LegalOnは、仕事に合ったモデルの選択基準を示し、必要な業務には予算枠を広げています。開発速度を維持しながら費用を抑えるため、モデル選択と予算配分を一体で管理しています。
Luna・Sol・Astraを何に使い分けたのか
LegalOnでは、AI活用を推進する組織「AID CoE」がモデルを検証し、現場に推奨する役割を整理しました。
| モデル | LegalOnでの主な担当 | 仕事の例 |
|---|---|---|
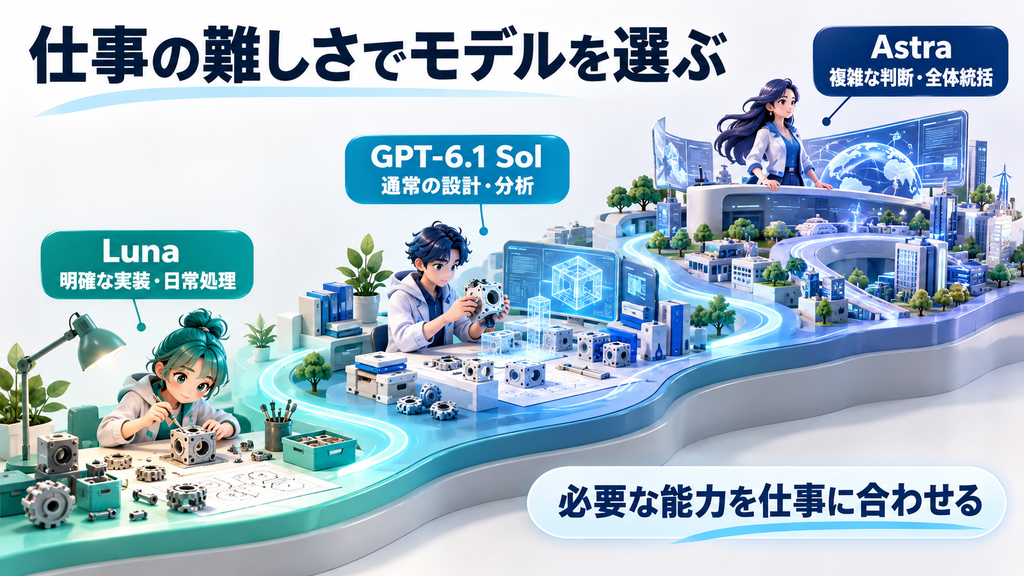
| GPT-6 Luna | 日常の実行、要件が明確な実装 | 決まった仕様のコード実装、単純な分析、日常の自動化、サブエージェント |
| GPT-6.1 Sol | 標準的な設計・分析 | 比較的単純な設計、数値分析、文書作成、Lunaより短時間で終わらせたい仕事 |
| GPT-6 Astra | 複雑な判断・設計・統括 | アーキテクチャ設計、難しい分析、複数エージェントの統括 |
表は、2026年10月8日に公開されたLegalOnの運用事例に基づく担当の目安です。仕事の内容と利用環境に応じてモデルを選ぶときの参考になります。
Lunaは「軽い仕事を任せる」ための選択肢
たとえば変更対象のファイルと修正内容が明確で、結果をテストで判定できる仕事なら、Lunaへ渡す余地があります。
依頼の前提が曖昧な仕事や、影響範囲の調査から設計まで必要な仕事には、より広い判断を担当するSolやAstraを検討します。
LegalOnはLunaを主にサブエージェントのコード実装にも利用しています。主担当が判断を持ち、範囲を限定した実装を軽量モデルへ任せる形です。
Solは日常の設計と分析の中心
Solは、日常の実装より広い判断が必要な設計や分析を担当します。
LegalOnの公開事例で挙がっているのは、標準的なソフトウェア設計、数値分析、資料作成です。また、Lunaに任せるより作業時間を短くしたい場合も選択理由になっています。
2026年10月時点のLegalOnの事例で使われている名称は「GPT-6.1 Sol」です。モデルの世代によって利用条件も変わるため、実際に選ぶ際は現在のモデル名を確認します。
Astraは難しい判断と全体の統括に使う
Astraは、複数の選択肢を比較する設計や、アーキテクチャ全体の判断、複数エージェントの作業をまとめる役割です。
仕事の規模、ツール呼び出し数、やり直し回数によってAstraの利用量は変わります。完了までの時間と消費量を合わせて見ながら使うモデルを選びます。
LegalOnでは、複雑な判断や全体の統括をAstraが担い、要件が明確な実装はLunaなどへ振り分ける運用を採用しています。
高性能モデルから始める仕事の条件
データ削除や権限設定に関わる変更、仕様が曖昧なシステム改修、復旧の難しい本番操作などは、失敗時の影響が大きい仕事です。こうした作業では最初から高度な判断を担当するモデルを選び、レビューとテストを組み合わせます。
テストが整っている小さなコード変更なら、Lunaで実装し、結果を検証する進め方もあります。設計判断が必要になった段階でSolやAstraへ切り替えます。
選択の基準は、やり直しやテストを含めて仕事を完了させるまでの費用と時間です。
Fast modeを原則制限した理由
Fast modeは、モデルの応答速度を優先する機能です。LegalOnでは当初、GPT-5.5をFast modeで制限なく使えるようにしていました。
その後はFast modeを原則制限し、待ち時間の短縮が重要な仕事では個別申請して利用する運用へ変更しました。
たとえば人が画面の前で結果を待っている緊急修正と、夜間に並列実行する検証では、速い応答へ追加の利用量を使う価値が違います。
OpenAIの案内によると、Fast modeは通常より多くの利用枠を消費します。速度の改善は主にテキスト生成に関するもので、ツール実行や多段階処理を含む仕事全体の所要時間は処理内容によって変わります。
Fast modeのAPI料金とCodexの利用枠
APIでは、GPT-6.1 SolのFast modeはStandardの2倍のトークン料金として案内されています。
ChatGPTのプランに含まれるCodex利用には、モデルと速度設定、思考レベル、仕事の内容に応じて共有の利用枠を消費する仕組みがあります。APIのトークン料金とは別の管理方法です。
個人向けプランで使える残枠や実際の消費量は、CodexやChatGPTの利用状況表示で確認します。Fast modeを使うときは、APIのドル単価とプランの利用枠をそれぞれの条件で確認します。
GitHubには、Fast modeで想定した速度が出なかったという利用者報告もあります。これは個別環境での報告です。実際の作業時間を比較すると、自分の環境でFast modeを使う価値を判断できます。
事業の段階に応じて予算を配分する
LegalOnはAI予算を部門・グループ・個人単位で管理しています。利用状況を見て、必要なら上限を引き上げる運用です。
興味深いのは、事業の状況によって予算の扱いを変えたことです。
- 成熟したLegalOn事業:最大約20%の効率化を求める方針
- 立ち上げ段階の新規事業:事業のスピードを優先し、AI活用へ厚めに予算を配分
成熟事業の「最大約20%」は、予算管理で掲げた効率化の方針です。実績として報告された日次推計コスト約65%減とは、対象も数字の意味も異なります。
開発を加速したい新規事業には予算を厚く配分し、成熟事業では効率化を進めることで、それぞれの事業に合う運用にしています。
モデル選択の指針はAID CoEがまとめ、マネージャーを通じて現場へ共有します。エンジニアが自分の仕事に合ったモデルを判断できる仕組みです。
約65%削減は何を測った数字か
OpenAIの2026年10月8日の導入事例は、LegalOnの日次推計コストがGPT-5.5中心の運用との比較で約65%減少したと説明しています。
ここは数字の読み方が重要です。
| 項目 | 公開情報から確認できること |
|---|---|
| 削減対象 | 日次の推計コスト |
| 比較の相手 | 従来のGPT-5.5中心の運用 |
| 取り組み | モデルの役割分担、Fast modeの制限、予算枠の配分と監視 |
| 開発速度 | 維持したと報告。並列実行などで補完 |
| 公開データの範囲 | 日次推計コストの比較まで。実請求額の削減率や仕事量をそろえた比較、各施策単独の寄与率は未公表 |
約65%という数字はLegalOnの当時の運用条件で得られた結果です。自分の環境での削減幅を考えるときは、仕事の種類や利用モデル、Fast modeの使い方も合わせて確認します。
旧運用と新運用ではモデル世代も使用方法も異なります。新モデルの低価格化、仕事の振り分け、Fast modeの制限、予算管理が組み合わさった結果を、日次推計コストの変化として捉える必要があります。
開発パフォーマンスについては、速度を維持したという報告が公表されています。比較条件をそろえた機能リリース数やバグ発生率などの詳細データは、公開情報の範囲外です。
この事例から参考にできるのは、モデルの使い分けと利用量の管理を組み合わせ、開発速度を維持しながら日次推計コストを下げた運用方法です。
自分のCodex運用へ取り入れるなら
個人開発なら、まず作業を3つに分けて、モデルの選び方を決めるところから始められます。
| 作業の特徴 | 最初に検討するモデル | 結果を確認するもの |
|---|---|---|
| 修正対象と完了条件が明確 | Luna | テスト結果、修正差分、仕様との一致 |
| 通常の機能設計や複数ファイルの調査 | Sol | 設計の整合性、実装結果、レビュー |
| 原因不明の障害、複雑な設計、複数エージェント統括 | Astra | 前提条件、失敗時の影響、テスト・レビュー |
これはLegalOnの担当分類を参考にした運用例です。実際には仕事の難しさと、自分のプラン・環境で選べるモデルや思考レベルに合わせて調整します。
1.作業の難しさを依頼時に判断する
仕事の難しさは、影響範囲や失敗時の損失によって変わります。数行の修正でも、本番データベースや権限に関わる変更には慎重な判断が必要です。
「影響範囲が明確か」「必要な情報がそろっているか」「テストで成功を判定できるか」「失敗した場合に戻せるか」を見て、モデルと確認方法を決めます。
2.軽いモデルで失敗したら、原因を切り分けてから切り替える
軽量モデルの作業が止まったら、指示の明確さ、参照できているファイル、テスト環境の状態を順番に確認します。原因を切り分けると、追加情報を渡すべきか、モデルを切り替えるべきか判断できます。
必要な情報がそろった状態で設計判断が難しい場合は、SolやAstraへの切り替えを検討します。
3.待ち時間を短縮したい仕事だけFastを検討する
Fast modeを常時有効にする前に、手元で待つ必要がある仕事なのか、並列実行や別作業を進められるのかを考えます。
「応答が速い」ことと「成果物が早く完成する」ことを分け、テストやレビューが終わるまでの時間で比較します。
4.利用量を「完了した仕事」と結び付ける
仕事ごとの費用を知るには、利用枠の残量やAPIの支出に加えて、作業単位の記録が役立ちます。小さな変更なら修正1件、大きな開発なら機能リリース1件を単位にし、利用量、やり直し回数、レビュー時間、テスト結果を記録します。
大きな仕事を短時間で正しく完了できれば、利用量が増えても支出に見合う成果を得られます。モデルの変更によって再作業が増えた場合は、その時間と費用も含めて比較します。
LegalOnも「機能リリース単位の費用対効果」は構築中
LegalOnは、機能リリース1件にかかったAIコストと、その機能が生む顧客価値を結び付ける指標の開発を進めています。2026年10月8日時点では、その計算の仕組みを構築中です。
日次の支出とあわせて、リリース数、不具合、顧客に届いた価値まで追うと、開発全体の成果を評価できます。
今回の事例を自社へ応用するなら、品質・完了までの時間・リリース単位のコストを合わせて記録する方法が投資判断につながります。
大量のエージェントを運用するときに、モデル、コンテキスト、ツール、キャッシュのコストをどう分解するかについては、UberのAI Software Factoryの事例でも詳しく扱っています。
まとめ
LegalOnは、Astra・Sol・Lunaの役割分担、Fast modeの制限、事業段階に応じた予算管理を組み合わせ、日次推計コストを約65%削減したと報告しています。
実務で取り入れたいのは、難しい判断へ高性能モデルを使い、範囲が明確な実装は軽量モデルに任せる役割分担です。テストやレビューを含む完了までの費用と時間を比べながら、使い分けを調整します。
支出は利用量で、成果は完了した仕事の質や速度で確認できます。仕事の種類別にモデルを選び、テストとレビューを含めた結果を比べながら、自分の開発環境に合う運用を育てていきたいところです。