当サイトではアフィリエイト広告を利用しています。
今日のAIニュース5選
実務でAIを使うための競争が、チャット画面の中だけではなく、その前後を支える仕組みへ広がっています。
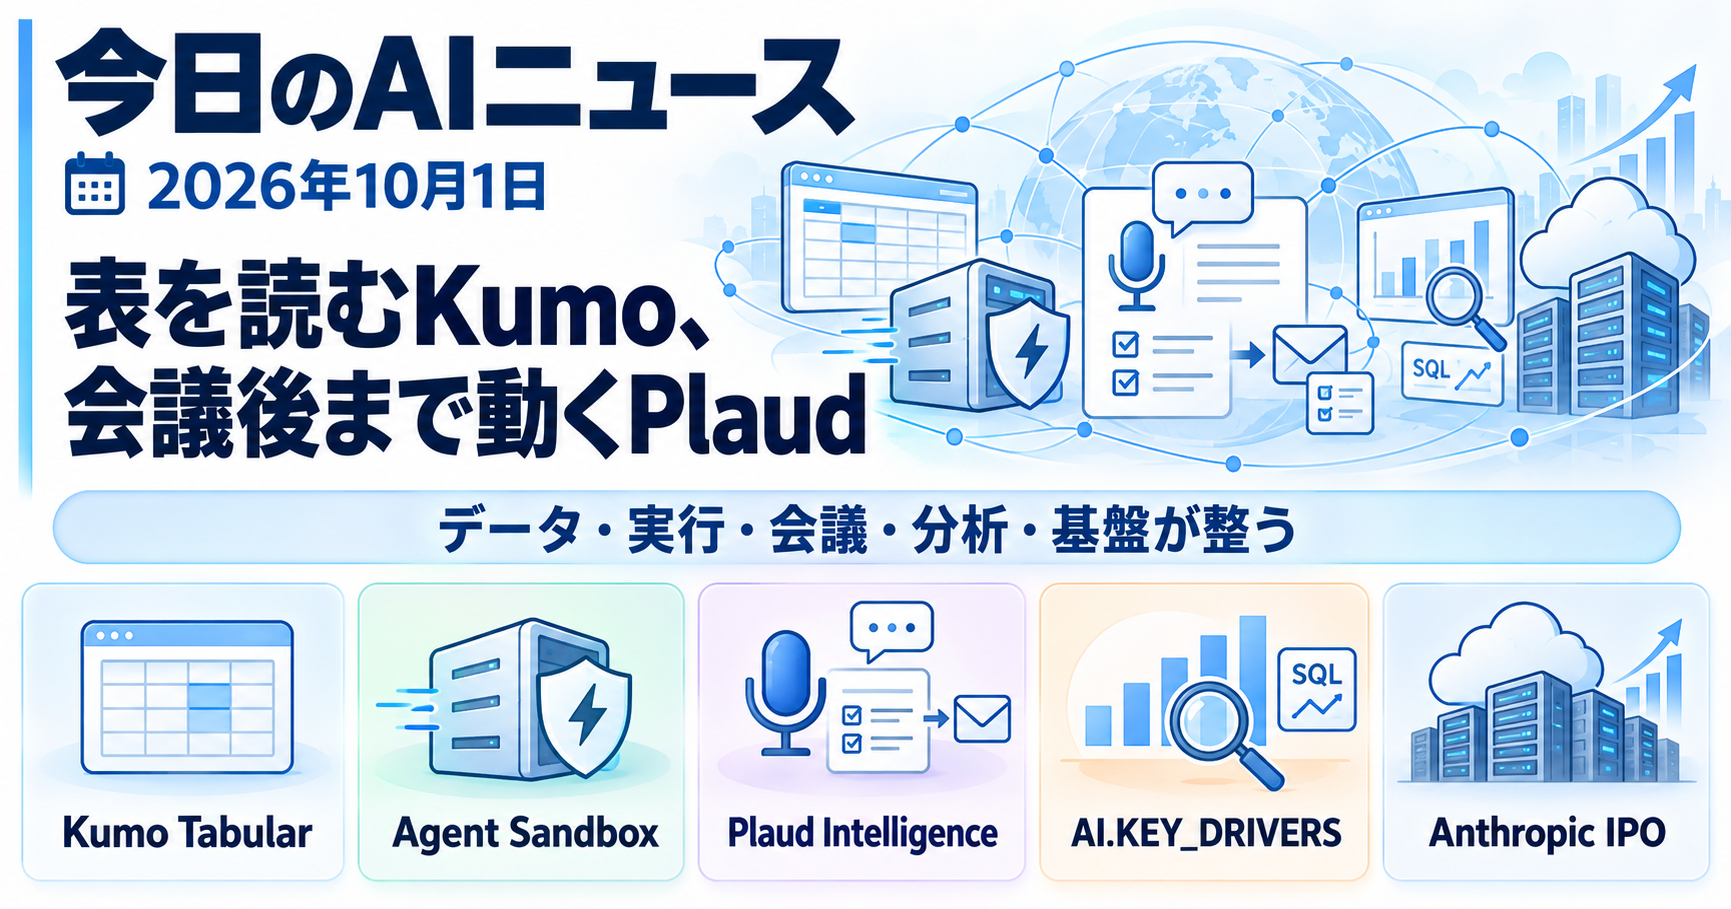
NVIDIAは、表形式データをそのまま読み、追加学習なしで分類や回帰を行う「Kumo Tabular」を公開しました。Google Cloudは、AIエージェントの強化学習や評価で使う実行環境「GKE Agent Sandbox」を高速化し、大量の並列実行で生じる待ち時間を大きく減らしています。
会議支援ではPlaudが、録音や要約で終わらず、会議後のメール作成やタスク共有まで進める新しいPlaud Intelligenceの詳細を発表しました。BigQueryでは、売上や利用量の変化を引き起こした要因をSQLから探せる AI.KEY_DRIVERS が正式提供になっています。
そしてAnthropicでは、ロイターが確認したIPO目論見書から、急成長の裏側でクラウドと計算基盤へ巨額の支出を計画していることが明らかになりました。
今日はこの5本から、モデルの性能だけでは見えにくい「データを読む」「安全に実行する」「会議後まで動く」「数字の原因を探す」「計算資源を確保する」という実務AIの土台が、どこまで細かく整い始めているのかを見ていきます。
1. NVIDIA「Kumo Tabular」公開 表形式データを追加学習なしで分類・回帰
NVIDIAは9月29日、表形式データ向けのオープンな基盤モデル「Kumo Tabular」を公開しました。
表形式データは、売上、顧客情報、センサーログ、保険請求、在庫など、企業の現場で最も多く使われるデータ形式の一つです。これまで分類や予測を行う場合は、用途ごとに特徴量を設計し、モデルを学習・調整してから利用する方法が一般的でした。
Kumo Tabularは、その流れを変えることを狙っています。ラベル付きの行と、予測したい行を同じテーブルとして渡すと、モデルがその場で文脈を読み取り、一度の推論で分類確率や数値予測を返します。NVIDIAによると、用途ごとの追加学習、チューニング、特徴量設計を行わずに使える設計です。
モデルはSmall、Medium、Largeの3サイズで、約2,800万から2億1,500万パラメータ。事前学習には実在する顧客データではなく、構造的因果モデルから生成した人工テーブルだけを使っています。
NVIDIAは、TabArena、BeyondArena、TALENT、ScoringBenchの4つのベンチマークで首位になったと説明しています。TabArenaではELO 1950を記録し、同社の評価条件では競合モデルより高速だったとしています。ただし、これらはNVIDIA側の評価を含むため、実際の業務データでは精度や校正を個別に確認する必要があります。
現時点では数値列とカテゴリ列が中心で、テキストや画像、日時はそのまま扱うのではなく前処理が必要です。それでも、CSVや業務データを扱うたびに専用モデルを一から作る必要が減るなら、表形式データにおける「基盤モデル」の使い方が広がる可能性があります。
モデルウェイトはHugging Face、コードはGitHubで公開され、OpenMDW 1.1ライセンスの条件下で商用利用も可能です。
2. Google Cloud「GKE Agent Sandbox」強化 エージェント実行環境を最大45倍高速化
Google Cloudは9月29日、AIエージェントの強化学習や評価向けに最適化した「GKE Agent Sandbox」と、Agent Sandbox RL orchestration SDKの一般提供を発表しました。
AIエージェントを訓練・評価するときは、コード実行やツール操作を安全に試すため、大量の隔離された実行環境を作る必要があります。問題は、GPUでモデルを動かす準備ができていても、CPU側のサンドボックス作成やコンテナイメージの取得に時間がかかると、高価なGPUが待ち状態になることです。
Google Cloudによると、今回の最適化では最初のコマンドを実行できるまでの時間を従来の45〜85秒から1〜9秒へ短縮し、条件によって10倍から45倍高速化しました。最悪ケースの待ち時間も7.5分から10秒未満へ短縮したとしています。
また、強化学習では一度に数千個のサンドボックスを立ち上げることがあります。新しいSDKではPodを毎回作り直すのではなく再利用する仕組みを採用し、コントロールプレーンで新規作成されるPod数を約3分の1に減らしたと説明しています。
ここで重要なのは、モデルの性能そのものではなく「モデルを何回試せるか」が研究速度を左右していることです。長時間動くAIエージェントでは、一つの回答だけでなく、多数の実行結果を比較しながら学習や評価を繰り返します。
推論モデルが高速化しても、その周囲の実行環境が遅ければ全体は速くなりません。GKE Agent Sandboxの更新は、エージェント開発ではサンドボックスも計算基盤の重要な一部になっていることを示しています。
3. Plaud Intelligence、会議後の作業まで自動化へ Agent・Skills・Routinesを公開
Plaudは9月30日、新しいPlaud Intelligenceについて、チーム向けのPlaud AgentやConnectors、Skills、Routinesの詳細を発表しました。
Plaudはこれまで、会議や対面会話を録音し、文字起こしや要約を作る用途が中心でした。新しいPlaud Intelligenceでは、その記録を読んで終わるのではなく、会議後に必要な作業までエージェントへ渡せるようになります。
Plaud Agentは、チームの会議履歴や共有コンテキストを参照しながら、フォローアップメールの下書き、担当者へのToDo共有、文書の作成などを行います。Slack、Gmail、Google Docs、Google Calendar、Outlook、Notion、Linear、Zapierなどとの接続も発表されています。
さらに「Skills」では、毎回同じ品質で処理したい仕事の手順を保存できます。「Routines」は、その手順を条件に応じて自動実行する仕組みです。たとえば「録音が終わったら要点を整理して保存する」「毎朝カレンダーを確認して会議準備をまとめる」といった処理を、自然言語で設定できます。
Plaudは新しいPlaud Intelligenceを10月に展開すると案内しており、エージェントが成果物を作成したりRoutineを実行したりする処理には新しいPlaud Creditsを使う仕組みも発表しています。一方、従来の文字起こしや標準要約はCreditsの対象外としています。
会議AIはこれまで「記録を残す」部分が中心でした。今回の変化は、会話を仕事の入力として、その後に発生する定型作業まで続けて処理する方向です。
4. BigQuery「AI.KEY_DRIVERS」正式提供 売上や利用量が変わった原因をSQLで探す
Google Cloudは9月29日、BigQueryの AI.KEY_DRIVERS 関数を一般提供しました。
この機能は、売上や利用量などの合計可能な指標が変化したとき、「どの地域」「どの商品」「どの顧客層」といったデータの組み合わせが、その変化に強く関係しているかを探すためのものです。
たとえば、新商品を発売した後に売上が予想以上に伸びた場合、地域と都市を軸にして、どのセグメントが変化を押し上げたのかをSQLから調べられます。BigQuery上のデータを外へ書き出さず、分析をデータウェアハウス内で完結できます。
従来のContribution Analysisでは、モデルを作成してから ML.GET_INSIGHTS を呼び出す方法があります。AI.KEY_DRIVERS は、対象が合計可能な指標で次元数が12以下などの条件に収まる場合、モデル管理をせず、より短いSQLで同様の分析を行えるようにしたものです。
生成AIというと文章や画像を作る機能が目立ちますが、企業では「なぜ売上が落ちたのか」「どの地域が変化の原因か」といった分析も日常的に発生します。AI機能がSQLの一部として入ることで、データ分析の現場ではチャットを開かなくてもAIを使う場面が増えていきます。
5. AnthropicのIPO目論見書、ロイターが報道 急成長の裏で計算基盤へ巨額投資
AnthropicのIPO準備をめぐり、ロイターは9月29日、同社のIPO目論見書を確認したとして財務情報を報じました。
ロイターによると、Anthropicの2025年売上高は約46億ドルで、前年から約12倍に増加しました。一方、営業損失は80億ドルを超え、純損失は約420億ドルに達したとされています。純損失には資金調達に関連する大きな会計上の評価損も含まれています。
さらに目を引くのが計算基盤への支出です。目論見書では、今後のクラウド、計算資源、インフラ関連の契約・支出義務として総額5,180億ドル規模が示されているとロイターは報じています。
AI企業のニュースでは、新モデルの性能や利用者数が注目されがちです。しかし、その裏側ではモデルを学習し、推論を提供し続けるために、GPU、データセンター、電力、クラウド契約へ巨額の資本が必要になります。
Anthropicの数字は、急成長している企業でも、最先端AIを継続的に提供するには莫大なコストがかかることを示しています。IPO時の評価額は2兆ドルを超える可能性があると報じられていますが、記事執筆時点では公開市場で確定した評価ではありません。
この話題は製品アップデートではありませんが、Kumo Tabularのような専門モデルやGKEの実行基盤が増えていく背景に、計算資源をどう確保し、どう効率化するかという巨大な経済問題があることを分かりやすく示しています。
まとめ
今日の5本を見ると、実務AIの進化は「もっと賢いチャットモデルを作る」だけでは説明できなくなっています。
Kumo Tabularは、表形式データを用途ごとに学習し直す手間を減らそうとしています。GKE Agent Sandboxは、エージェントの学習や評価を支える実行環境そのものを高速化しました。
Plaudは会議内容を記録するだけでなく、その後の仕事まで進めるエージェントへ広がっています。BigQueryでは、業務指標が変化した原因をSQLから直接探せるようになりました。
そして、そのすべてを大規模に動かす側では、Anthropicの目論見書から計算基盤に必要な資本の大きさが見えてきます。
モデルを選ぶだけではなく、どのデータを読むか、どこで安全に動かすか、どの業務へつなぐか、どう分析するか、そして計算資源をどう確保するか。実務AIの競争は、こうした土台の部分へ一段深く入っています。
今日の注目アイテム
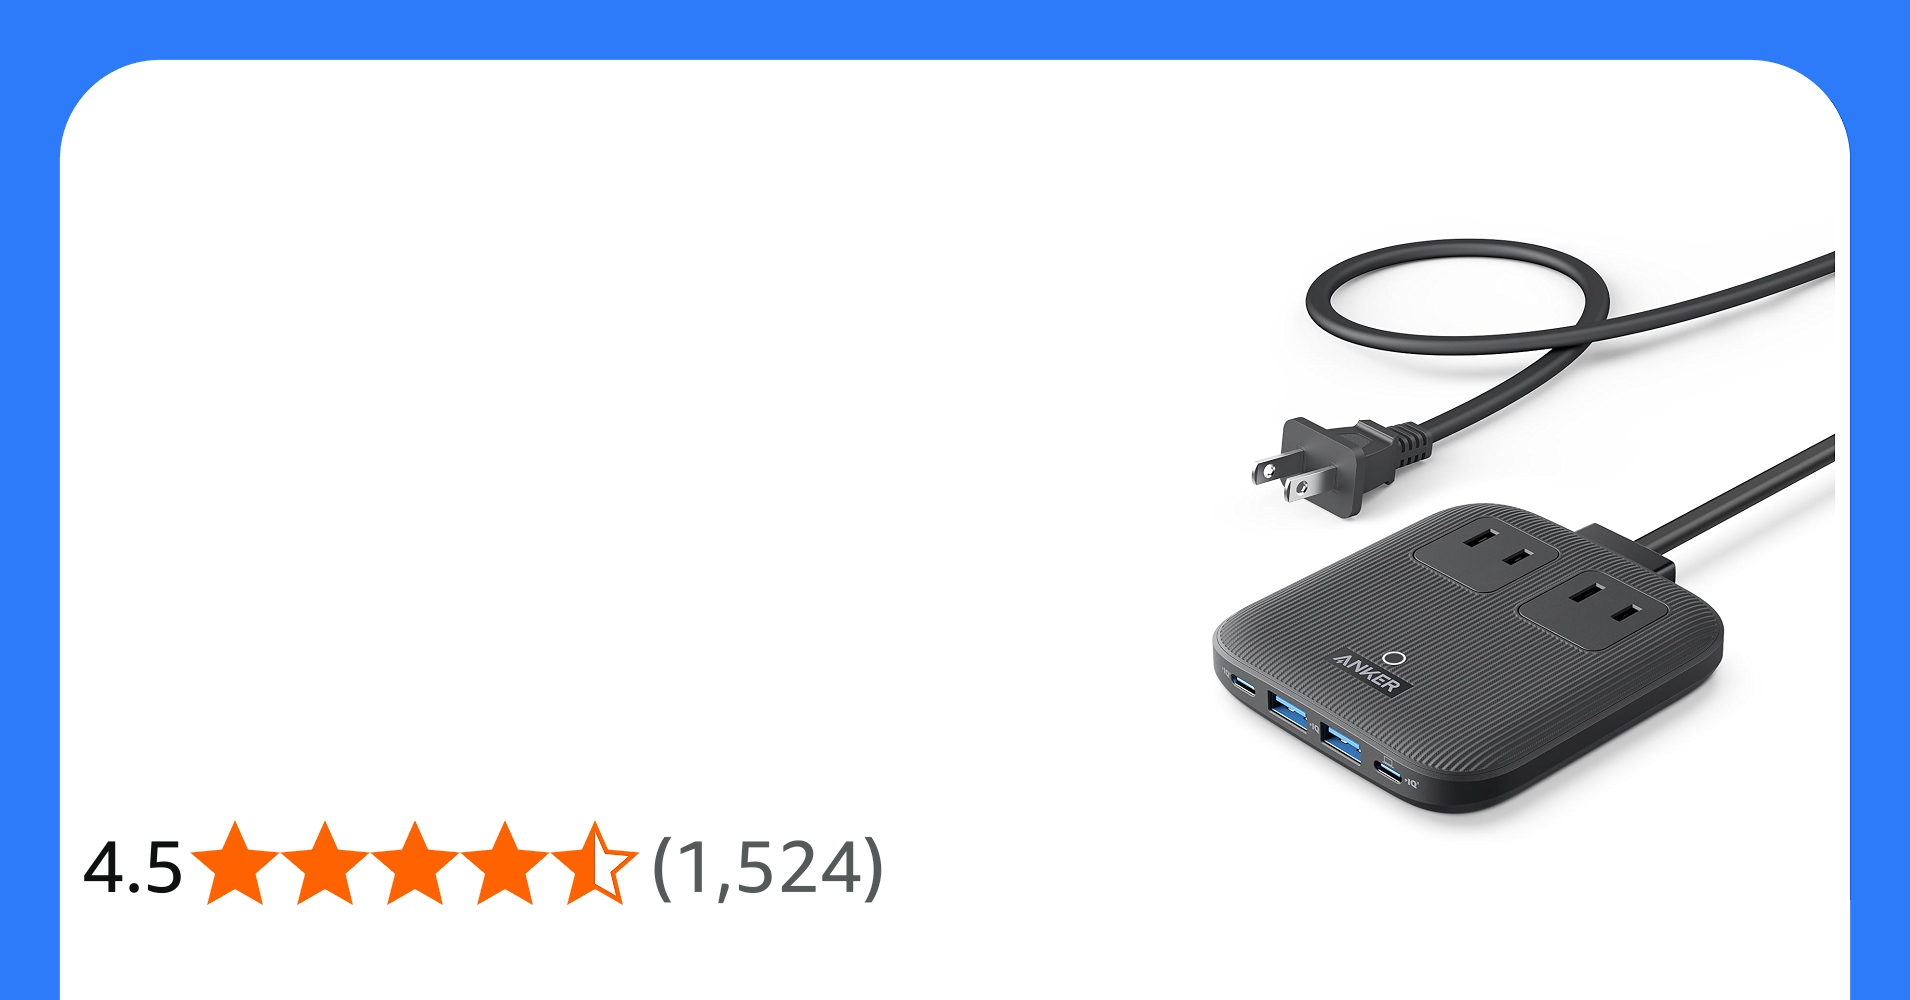

AnkerのNano Charging Stationは、AC差込口2口とUSB-C・USB-A各2ポートを備えた、67W出力の6-in-1電源タップです。 1.5mの延長コードとPSE技術基準適合仕様で、MacBookやWindows PC、iPad、iPhone、Galaxyに対応しています。
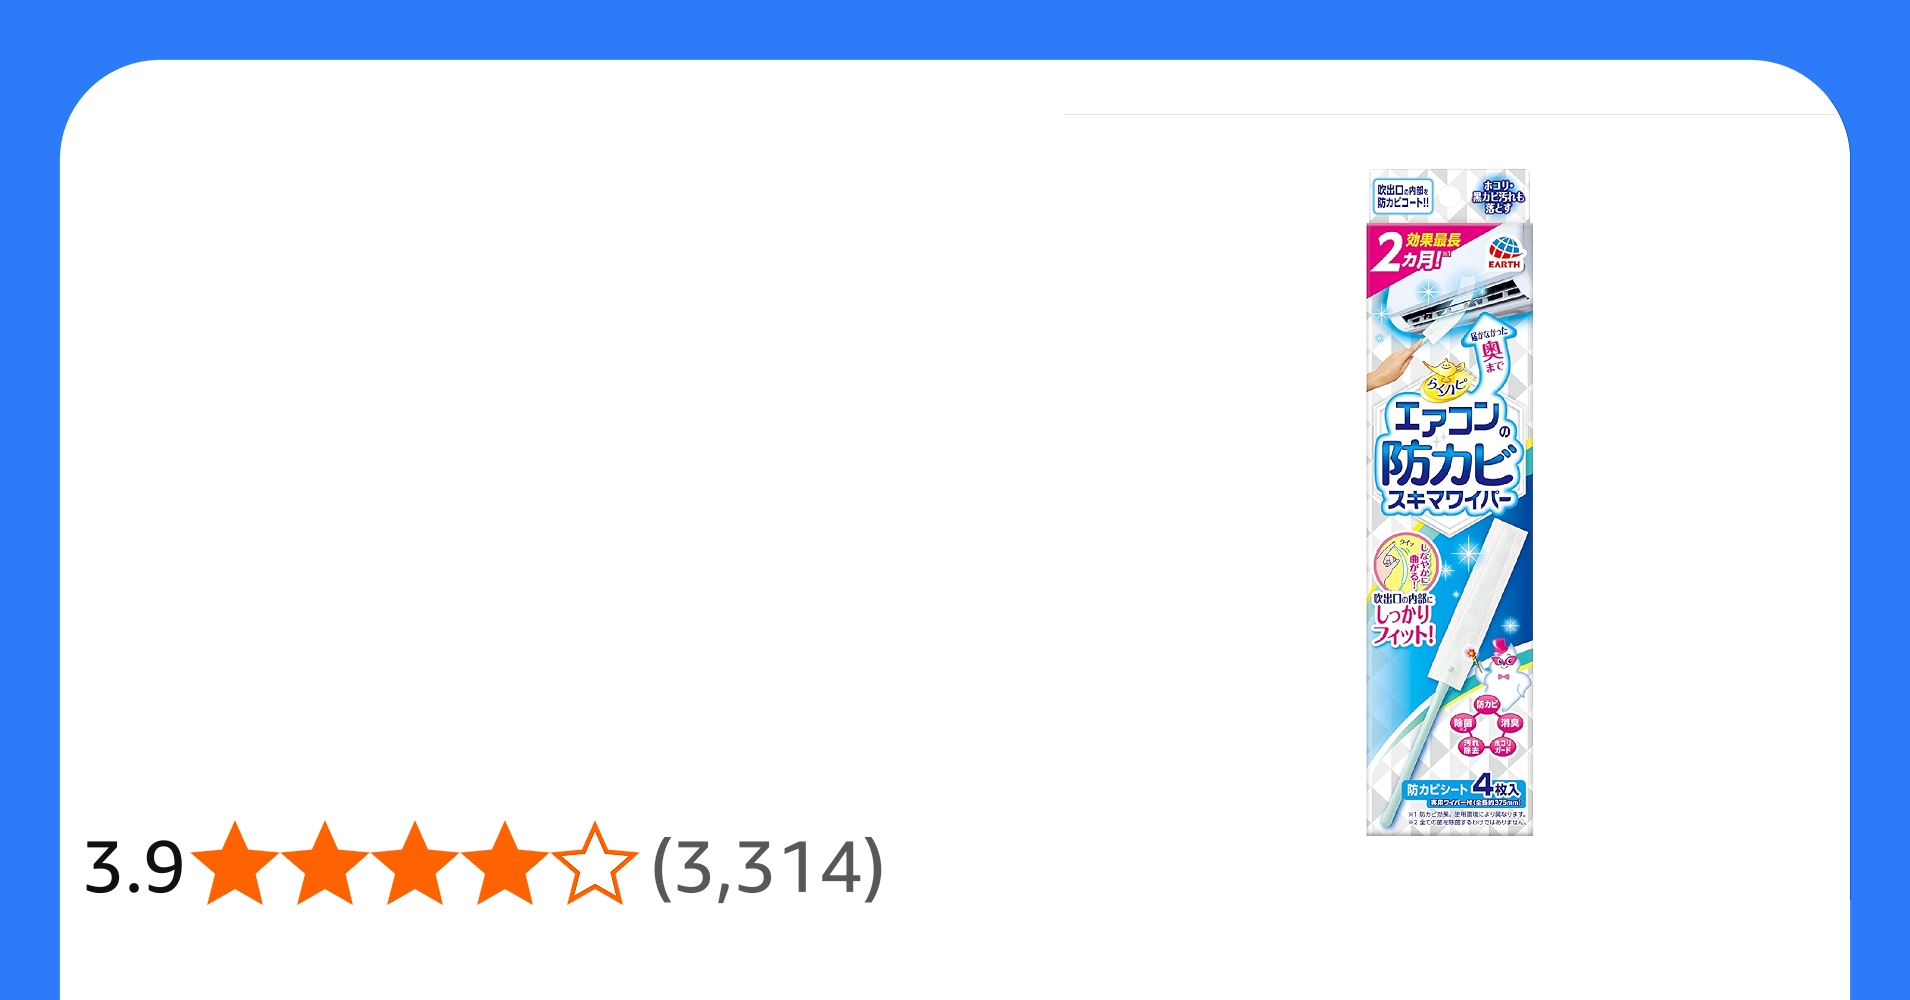

らくハピのエアコン用防カビスキマワイパーセットで、無香料タイプです。 ワイパー本体1個とシート4枚がセットになっています。
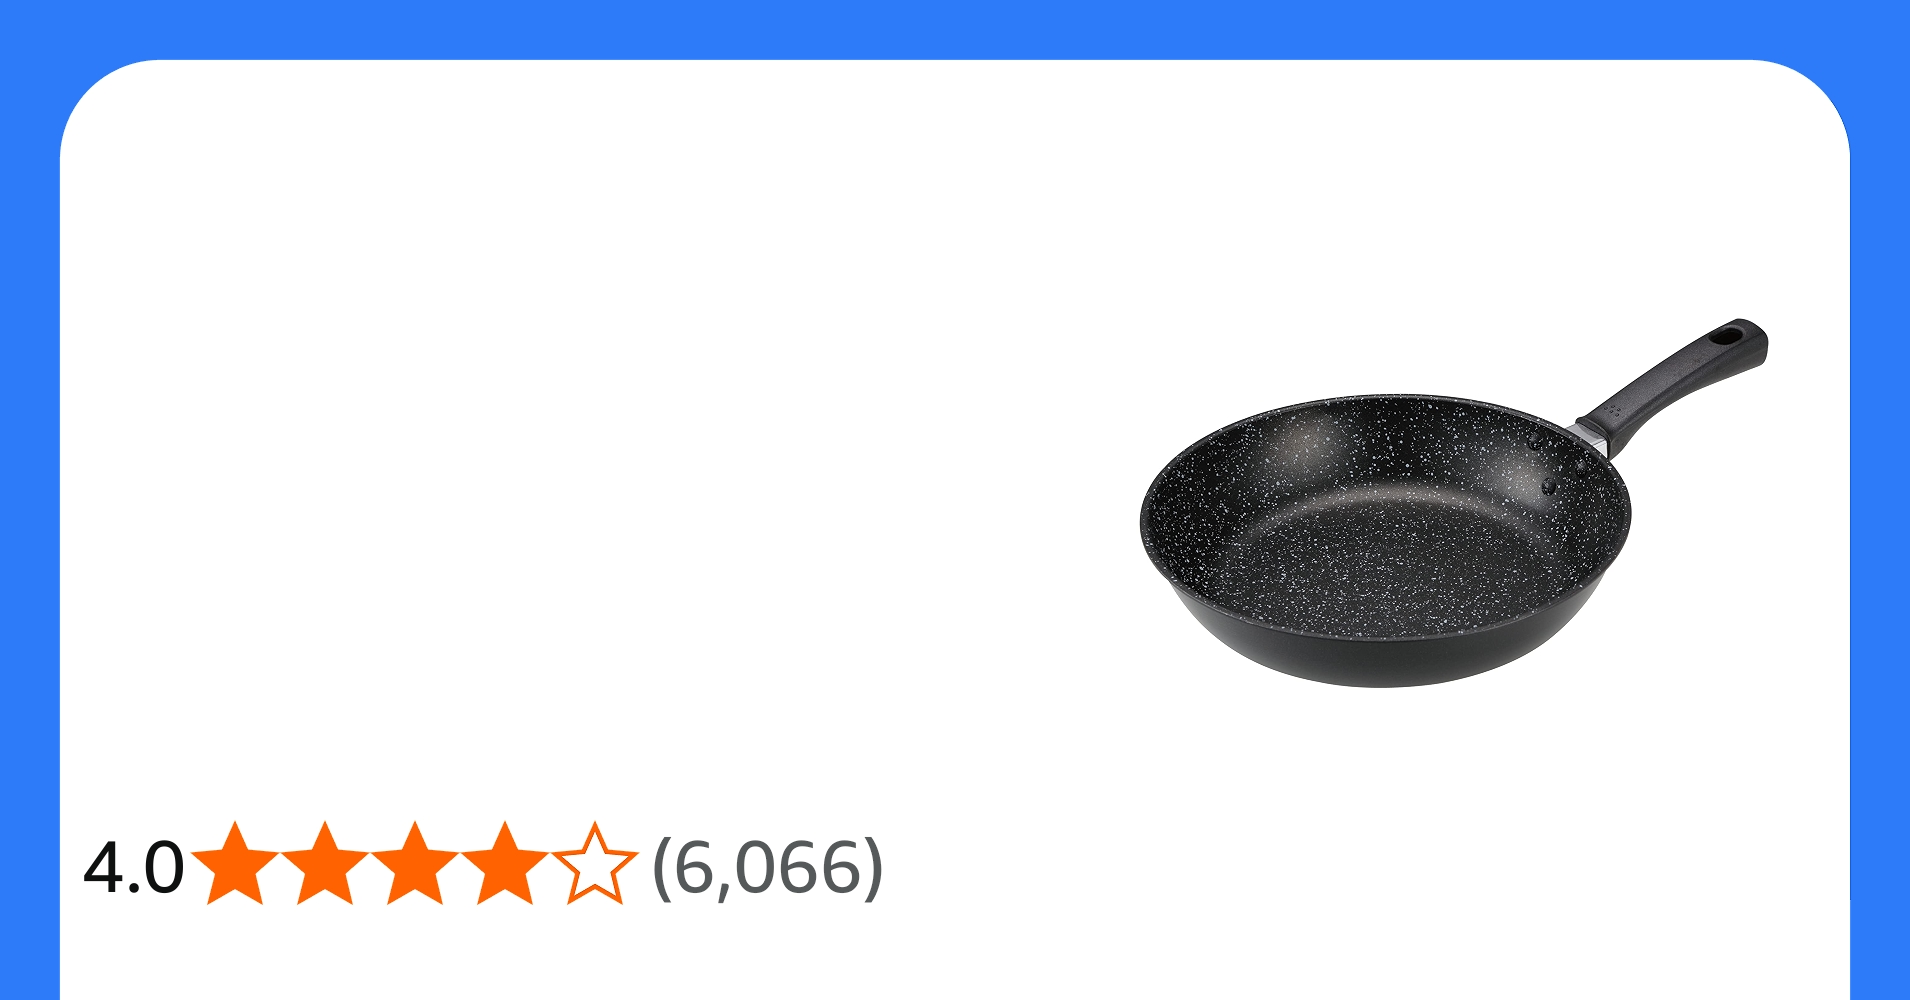

貝印 KAIの軽量フライパンで、直径26cmの高熱効率タイプです。 ガス火とIHに対応し、PFOA・PFOSフリー仕様です。
公式情報・参照先
- Hugging Face / NVIDIA:NVIDIA Kumo Tabular Sets a New Accuracy-Efficiency Frontier for Tabular Prediction
- Google Cloud:Accelerating agentic RL and evaluation research velocity with 45x faster GKE Agent Sandbox
- Plaud:Getting Your Plaud Team Ready for the New Plaud Intelligence
- Plaud:Plaud now runs your workflow for you
- Google Cloud:BigQuery release notes
- Google Cloud:The AI.KEY_DRIVERS function
- Reuters:Anthropic’s IPO prospectus sharpens focus on AI valuations