当サイトではアフィリエイト広告を利用しています。
今日のAIニュース5選
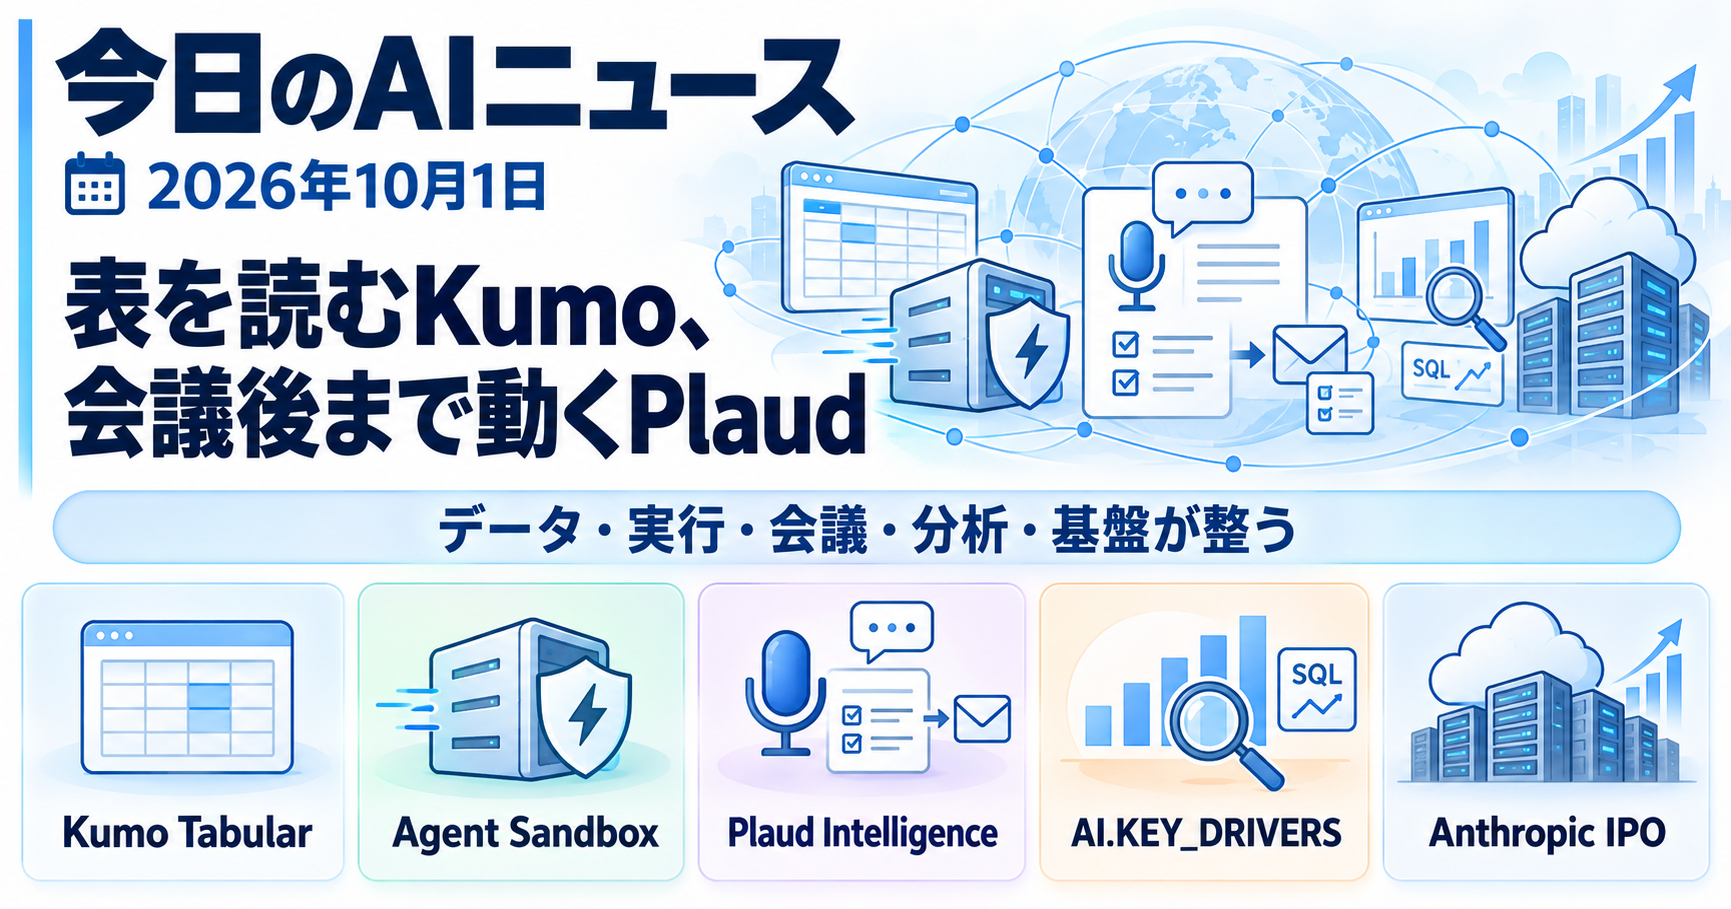
生成AIの使い方が、「一番強いモデルを1つ選ぶ」だけでは説明できなくなってきました。
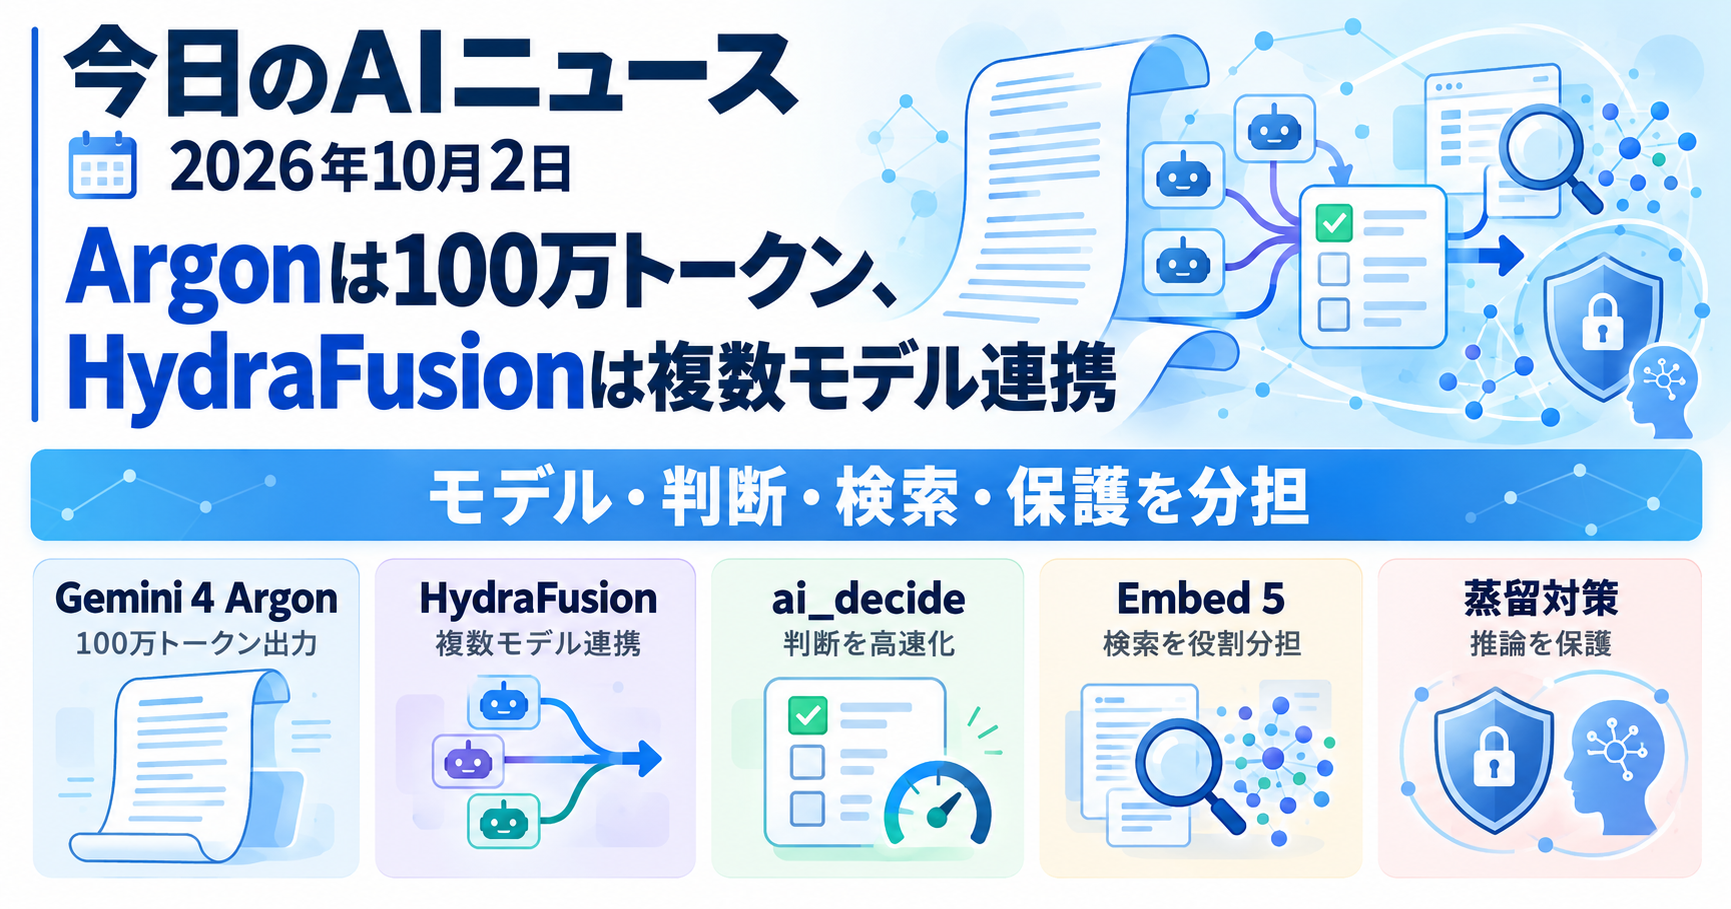
Googleは、長時間のソフトウェア開発や金融・法務、サイバー防御を想定した新しい最上位モデル「Gemini 4 Argon」を発表しました。一方GitHubは、1つのモデルを固定して使うのではなく、依頼内容に応じて複数モデルと実行方法を組み合わせる「HydraFusion」をVS CodeとGitHub Copilotアプリへ広げています。
Databricksは、文章生成をさせず「分類する」「選ぶ」「採点する」といった判断だけを高速に返す ai_decide を公開しました。Cohereの「Embed 5」も、検索やRAGのための埋め込み処理に特化し、精度重視のProと速度重視のFastを同じ埋め込み空間で使い分けられる設計になっています。
さらにOpenAIは、自社モデルの保護された推論を大規模に取り出そうとした「敵対的蒸留」のキャンペーンを検知し、遮断したと公表しました。
今日はこの5本から、巨大モデルそのものの能力だけでなく、モデルをどう組み合わせるか、どの処理を専門モデルへ任せるか、そして高度な推論をどう守るかまで、AIの役割分担が細かくなっている流れを見ていきます。
1. Google「Gemini 4 Argon」発表 出力上限を100万トークンへ拡大
Googleは9月30日、新しいフロンティアモデル「Gemini 4 Argon」を発表しました。
Argonは、短い質問へ答えるチャット用途より、長時間続く複雑な仕事を強く意識したモデルです。Googleは、実際のソフトウェア開発、金融・法務などの企業向け知識労働、サイバーセキュリティ防御を主な用途として挙げています。
大きな特徴の一つが、出力できるトークン数の上限です。従来の6万4,000トークンから100万トークンへ大幅に拡大しました。これは入力できる文脈長ではなく、1回の実行でモデルが生成できる出力側の上限です。
長いコード修正や調査では、途中で処理を区切るほど前後の整合性を保つのが難しくなります。非常に長い出力を一続きで扱えることは、モデルが何時間もかかる作業を一つの軌跡として進める設計と相性があります。
Googleが公開した評価では、長時間のソフトウェア開発を測るDeepSWE v1.1で77.9%を記録しています。ただし、現時点の数値はGoogle側が公開した評価が中心で、第三者による検証はこれからです。
提供方法にも特徴があります。Argonは記事執筆時点で一般のAPI利用者へ広く提供されているわけではなく、まずは「Fairwind Program」を通じて、審査されたサイバー防御組織へ展開されています。
高性能なモデルほど、能力を一気に一般開放するのではなく、用途や利用者を限定しながら段階的に出す流れが強くなっています。
2. GitHub「HydraFusion」拡大 1つのモデルではなく実行方法まで自動選択
GitHubは9月30日、GitHub Copilotの研究プレビュー機能「HydraFusion」を、VS CodeとGitHub Copilotアプリでも利用できるようにしました。これまではCopilot CLIが中心でした。
HydraFusionは新しいAIモデルの名前ではありません。依頼ごとに、どのモデルをどのような順番で使うかを決めるオーケストレーション機能です。
現在は3種類の実行パターンがあります。
「Single」は1つのモデルでそのまま解決する方法です。「Cascade」は、まず軽量なモデルに解かせ、その結果が基準を満たさなければより強いモデルへ引き上げます。「Critique」では、あるモデルが作った案を別のモデルファミリーが読み取り専用でレビューし、最初のモデルがその指摘をもとに1回修正します。
GitHub Copilotにはすでに、リクエストごとに適切なモデルを選ぶ「Auto」があります。HydraFusionはさらに一歩進み、モデルだけでなく「単独で処理するか、段階的に強いモデルへ渡すか、別モデルにレビューさせるか」まで選びます。
対象はCopilot Pro、Pro+、Business、Enterpriseで、BusinessとEnterpriseでは管理者によるプレビュー機能の許可が必要になる場合があります。現時点では正式版ではなく研究プレビューです。
コーディングAIでも、最強モデルを常に使うのではなく、簡単な仕事は安く速く処理し、難しいときだけ強いモデルやレビュー工程を追加する考え方が具体的になっています。
3. Databricks「ai_decide」公開 文章を生成せず判断だけを高速に返す
Databricksは9月30日、新しいAI Function「ai_decide」をベータ公開しました。
一般的な大規模言語モデルは、文章を生成することを前提に設計されています。しかし実際の業務では、「この問い合わせはどのカテゴリか」「人間の確認が必要か」「どのモデルへ渡すべきか」といった、長い文章を作る必要のない判断が大量に発生します。
ai_decide は、こうした処理に特化した決定モデルを使います。文章と質問を渡すと、確率、指定した選択肢、段階評価などの構造化された結果を返します。
Databricksは、通常のLLMで同じ判断を行うより低遅延・低コストになると説明しています。SQLから大量データへ適用できるほか、REST APIを通じてリアルタイムのアプリやAIエージェントから呼び出すこともできます。
用途としては、顧客レビューの分類、文書の確認要否判定、エージェントの評価、ユーザーの依頼を適切なモデルへ振り分けるルーティングなどが挙げられています。
以前から、TypeSafe AIのJevのように「文章生成ではなく候補を評価して決める」タイプのモデルが出てきました。Databricksがこの考え方をSQLや業務データ基盤の中へ直接持ち込んだことで、判断専用モデルが一般的なデータ処理の部品として使われ始めています。
4. Cohere「Embed 5」公開 精度重視と速度重視を同じ検索基盤で使い分け
Cohereは9月30日、新しい埋め込みモデル群「Embed 5」を公開しました。
埋め込みモデルは、文章や画像を数値のベクトルへ変換し、意味の近い情報を検索するためのモデルです。RAGや企業内検索、AIエージェントが必要な資料を探す処理の土台になります。
Embed 5には、検索精度を重視する embed-v5.0-pro と、低遅延・高スループットを重視する embed-v5.0-fast の2種類があります。
面白いのは、2つが同じ埋め込み空間を共有している点です。Cohereは、文書を登録するときは精度重視のProを使い、実際に大量の検索を行うときはFastを使う構成を推奨しています。データを作り直さず、処理ごとに品質と速度を切り替えられます。
テキストだけでなく画像やPDFページのような複合データにも対応し、100を超える言語、最大128Kトークンの入力を扱えます。埋め込みの次元数も256から2048まで選択でき、保存容量や検索性能に合わせて調整できます。
Embed 5はCohereのEmbed APIのほか、Microsoft FoundryやAmazon SageMakerでも利用できます。
生成モデルがどれだけ賢くなっても、企業内の正しい文書を見つけられなければ実務では使いにくいままです。検索専用モデルにも「精度を上げる役」と「高速に問い合わせる役」を分ける設計が入ってきています。
5. OpenAI、敵対的なモデル蒸留キャンペーンを遮断 保護された推論を大規模に抽出
OpenAIは9月30日、自社モデルから保護された推論を取り出そうとする大規模な「敵対的蒸留」のキャンペーンを検知し、遮断したと発表しました。
蒸留は、強いモデルの出力を使って別のモデルを学習・改善する手法です。それ自体は一般的な技術ですが、今回問題になったのは、通常は利用者へ見せない内部の推論を意図的に取り出し、別のモデルの能力向上に使おうとする動きです。
OpenAIによると、攻撃者が暗号を破ったり、データベースや利用者の会話履歴へ侵入したりしたわけではありません。モデルとのやり取りを操作し、保護された推論が利用者から見える形で出力されるよう試みていました。
7月24日と25日には、関連する抽出パターンで4,000人を超える利用者から約1万6,000件のリクエストが確認され、その後の調査では1万5,000人を超える利用者群に関連する活動が見つかったとしています。
OpenAIは、活動すべてが単一の主体によるものかは不明としたうえで、中心的な一群についてはKimiを開発するMoonshot AIに関係する人物へ帰属すると評価しています。これはOpenAI側の調査と帰属判断であり、すべての活動主体を確定したものではありません。
対策として、不正アカウントの停止、監視強化、ストリーミング出力から推論が漏れる経路の防止などを実施したとしています。
モデルの競争が激しくなるほど、価値があるのは公開された回答だけではありません。どのように問題を解いたかという内部の推論そのものが、守るべき技術資産になっています。
まとめ
今日の5本を見ると、AI開発の重心が「万能な1モデル」から、複数の専門的な層を組み合わせる方向へ移っていることが分かります。
Gemini 4 Argonは、非常に長い出力を扱いながら複雑な仕事を進めるフロンティアモデルです。一方HydraFusionは、1つのモデルに固定せず、仕事に応じてモデルと実行方法を組み合わせます。
Databricksの ai_decide は文章生成から判断だけを切り出し、Cohere Embed 5は検索専用モデルの中でも精度と速度の役割を分けました。
その裏側ではOpenAIが、モデル内部の推論を外部から抽出しようとする敵対的蒸留への対策を進めています。
これからのAI活用では「どのモデルが一番強いか」だけでなく、どの処理をどのモデルへ任せ、どう組み合わせ、どの情報を守るかまで含めた設計が重要になっていきます。
今日の注目アイテム
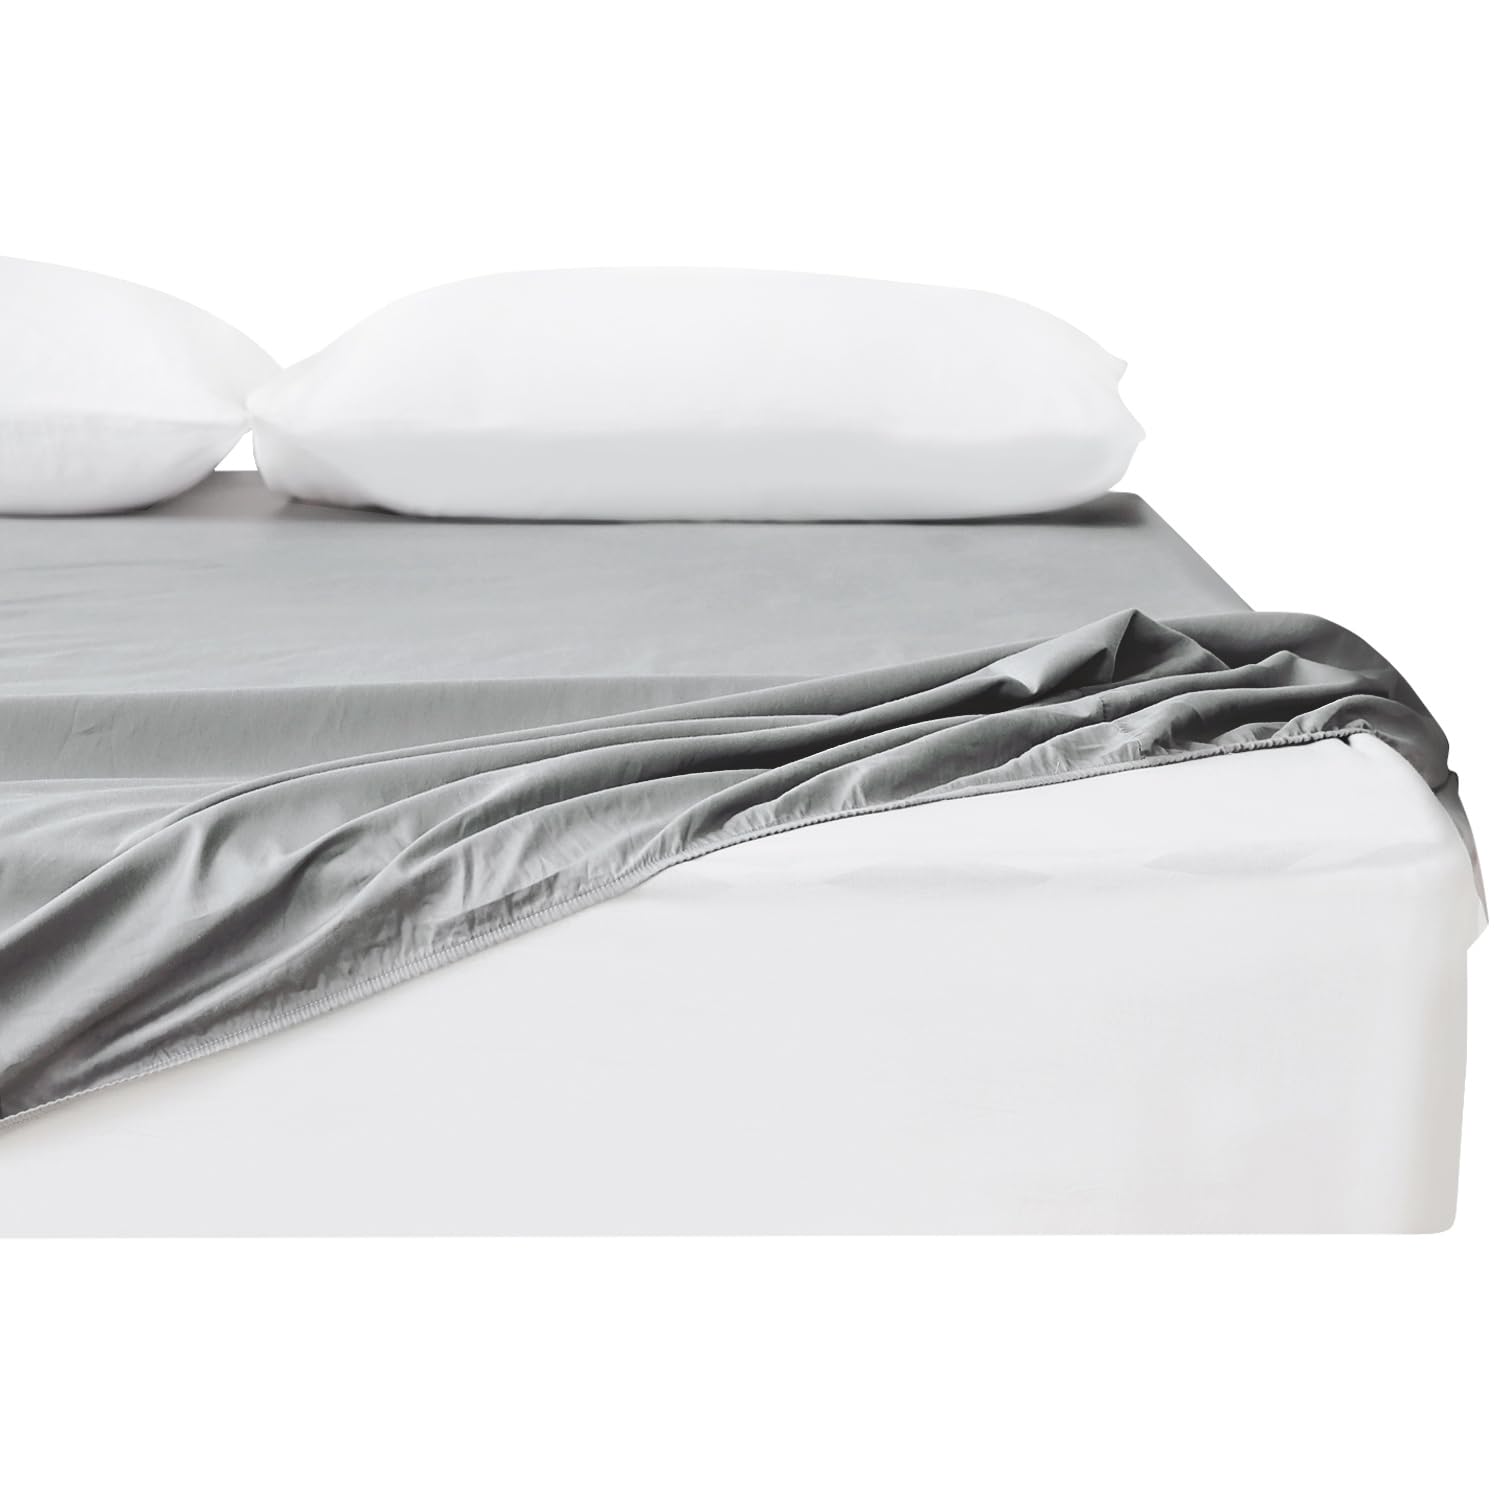

綿100%のシングル用ボックスシーツで、サイズは100×200cm、カラーはグレーです。 ベッド・マットレス・敷き布団に対応し、洗濯可能で吸水速乾と案内されています。
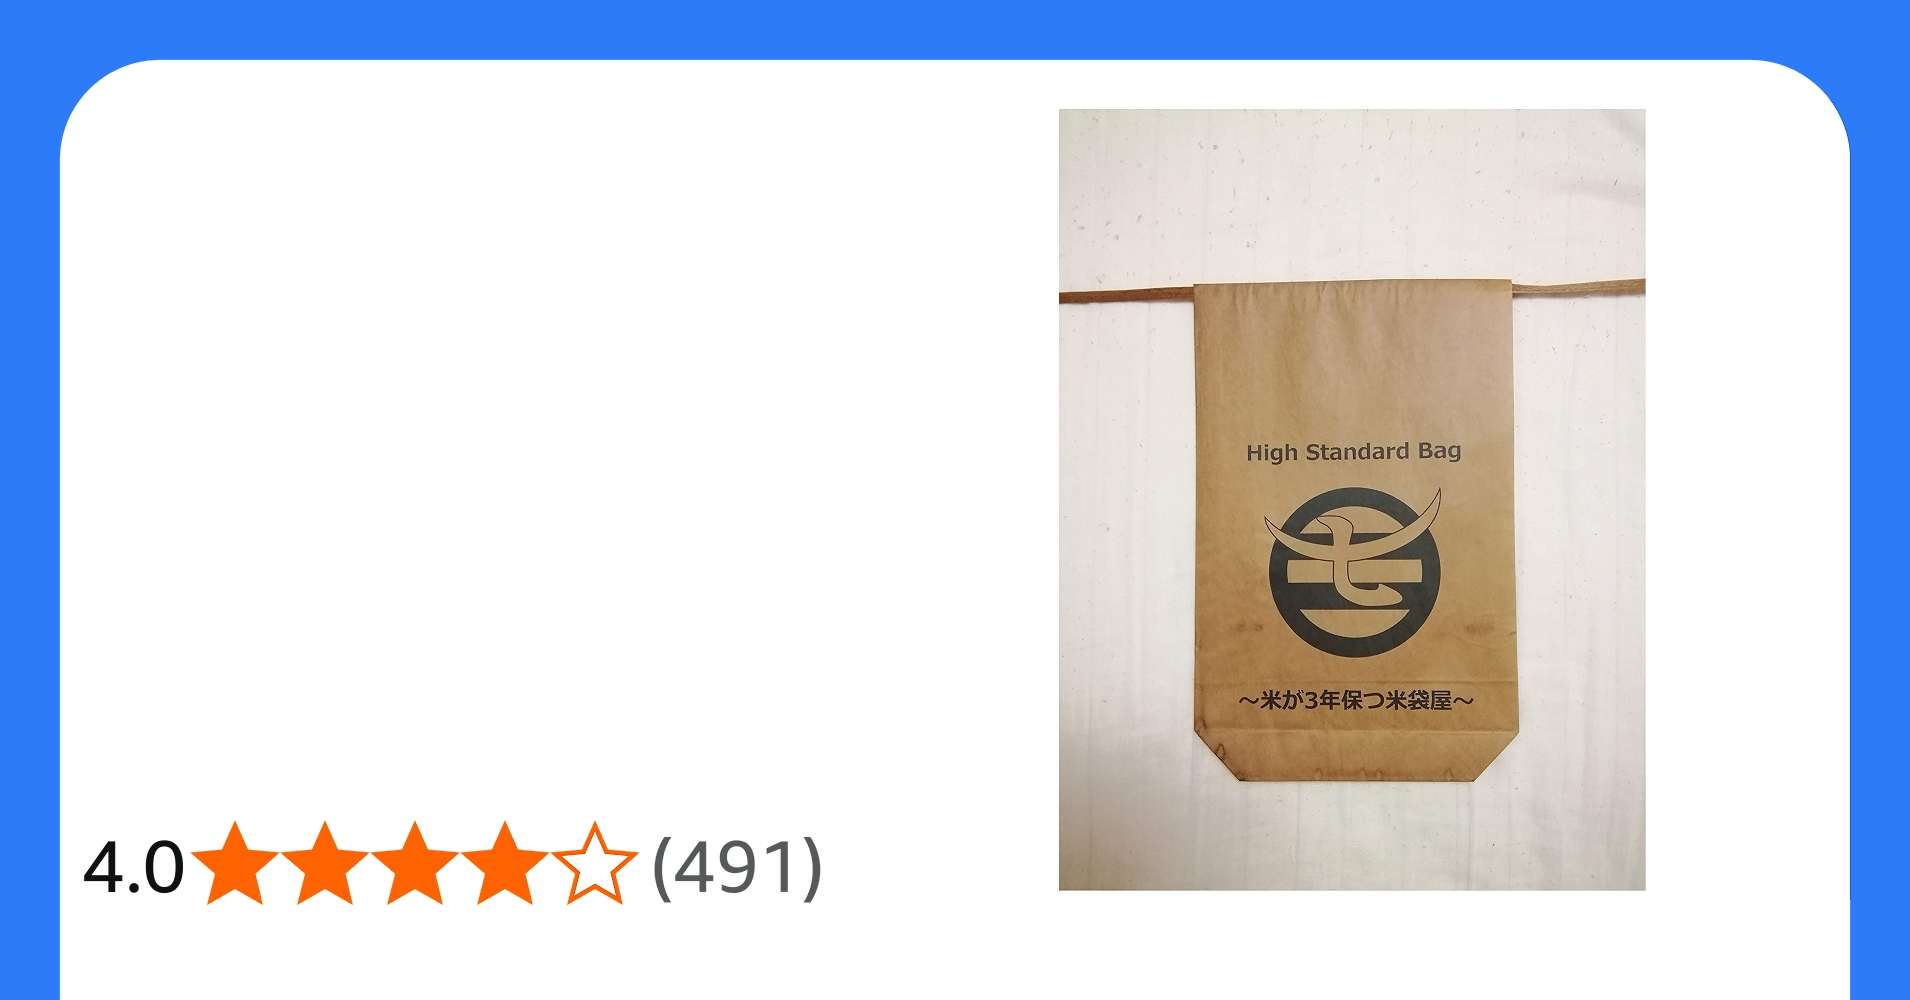

5kg用の柿渋ハッスイ米袋で、3枚入りのHigh Standard Bagです。 お米の保管に使える米袋として、商品ページでは「米が3年保つ」と案内されています。
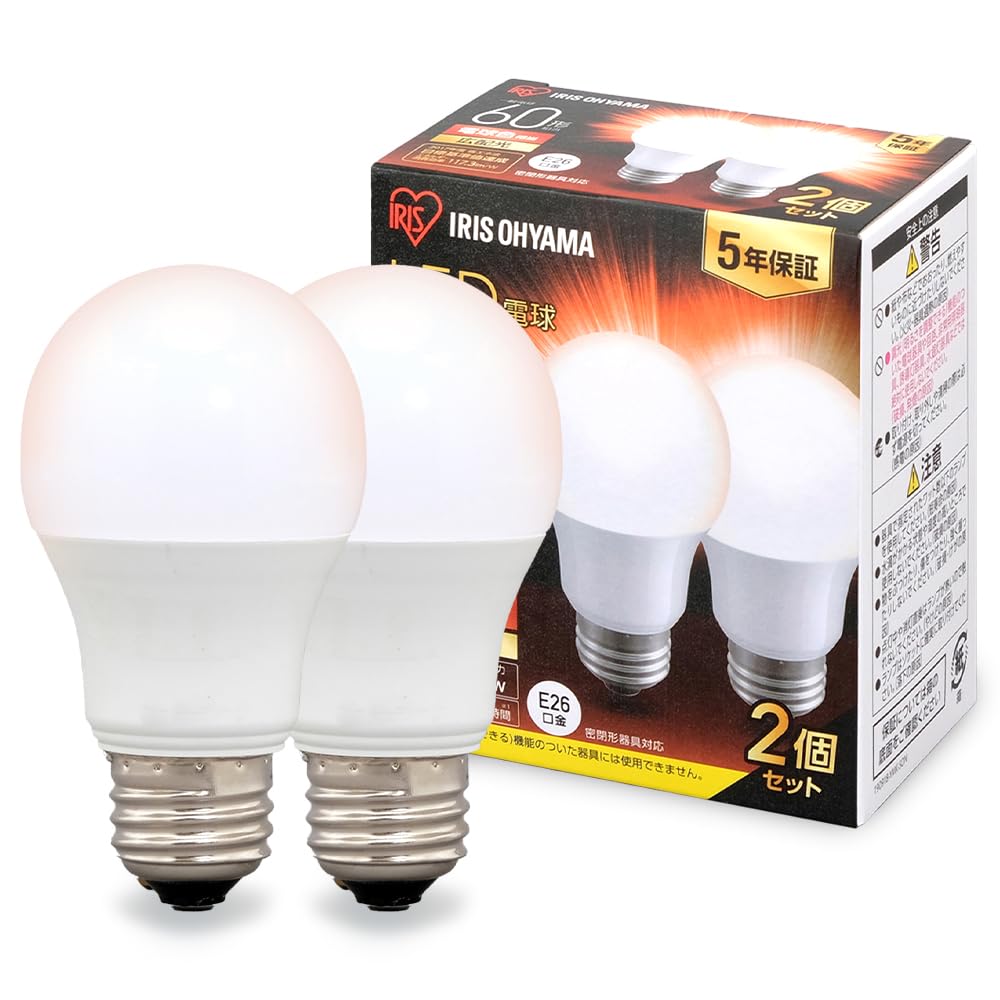

アイリスオーヤマの電球色LED電球で、口金直径26mm・60W形相当の広配光タイプです。 密閉器具に対応した2個パックで、家庭の照明に使いやすい仕様です。
※アフィリエイトリンクを含みます。